我给 dsh 装了第二个记忆服务
我的 DeepSeek Harness 里一直挂着 memorix,用了几个月,没出过问题。
昨天翻 ai-memory 的仓库,支持矩阵里有一行 DeepSeek Harness,状态写的是 MCP only。一个记忆服务专门给 dsh 留了适配位,这我得试试。
装上跑了一晚上,结论先说:它不是「更好的记忆」,是另一种记忆的分层法。选错层,比选错工具麻烦得多。
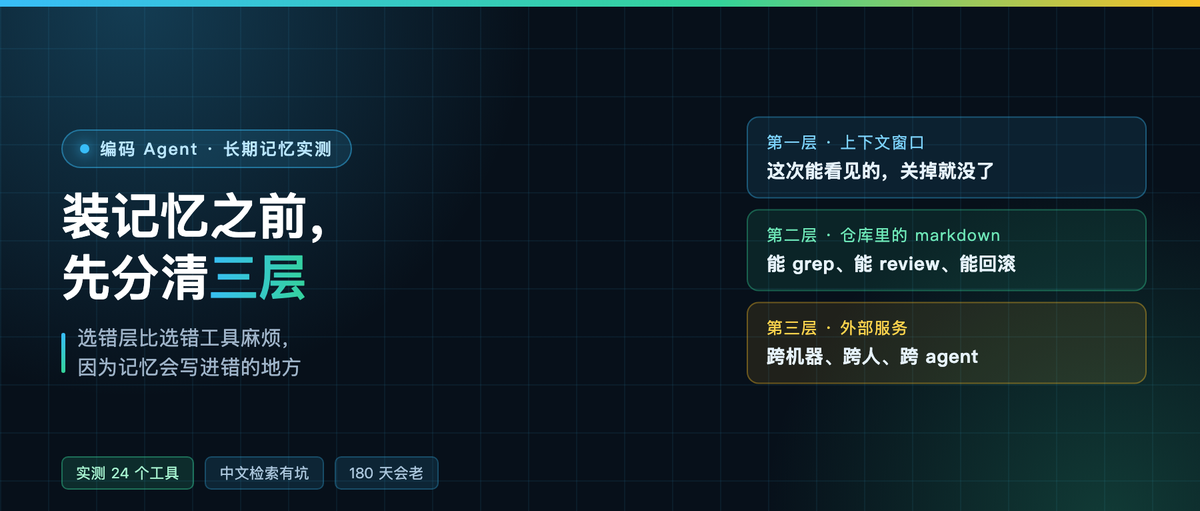
记忆其实有三层
第一层在上下文窗口里。模型这次能看见的东西,会话一关就没了。压缩、截断、换模型,全丢。
第二层在仓库里。AGENTS.md、笔记、一个小 wiki,git 管着,能 grep,能 review,git diff 能看出这次到底改了什么。
第三层在外部服务里。一个后台进程活着,跨机器、跨人、跨 agent,谁连上都读得到同一份。
市面上大部分 Agent 记忆工具说的是第三层,做出来却挤在第一层,无非是把摘要重新塞回 prompt。ai-memory 特别的地方是三层都碰了一下:第一层当入口,第二层当底座,第三层才是它真正的活。

装进去的是什么东西
macOS 版压缩包 17,817,781 字节,sha256 跟官方发布的一字不差。解开就是一个文件,39,835,136 字节,没有运行时依赖,跑 --version 回 3.1.2。
它的数据目录只有三样:wiki 存 markdown,db 存 SQLite 索引,raw 存原始观测。真身是 wiki 那一堆普通 markdown 文件,索引可以随时重建。
我写了三页进去,磁盘上就是三个文件,435、446、585 字节,跟手写的笔记没有任何区别。这一条比什么功能都值钱,因为文件是你的,工具跑了笔记还在。
它真正的新意是「只能被领一次」
工具列表里有一组 handoff:begin、accept、list、cancel。一次交接有主人,只能被认领一次,领了就归你。
还有一组 message:send、list、pop、cancel,跨项目发消息,一条被 pop 出来就算认领。
这两组东西严格说不是记忆,是排班。你早上用 Claude Code 干到一半,晚上换一个 agent 接着干时,真正难的不是「它忘了什么」,是「谁负责这段没干完的活」。它把这件事做成了协议。
dsh 那边只给 MCP,不给钩子
install-mcp --client dsh 的输出自己写得明明白白:print only,MCP only,no lifecycle capture。
生成的片段用的插件是 @deepseek-ai/dsh-mcp-client,跟我 cordis.patch.yml 里 memorix 那条一模一样,差别只在 command 和 args。
这句话翻译过来就是:在 dsh 上它不会自动记。没有生命周期钩子,就没有「会话结束时自动落页」这一步。想让 dsh 记住点东西,得让 agent 主动去调 write page。
这是我在两台机器上都在用的提醒:支持矩阵上写着「支持」,不等于体验一致。MCP only 那一行字,代价全在自动采集上。
工具面,24 对 20
同一个 MCP 探针,先 initialize 再 tools list,跑出两个数字。
ai-memory 3.1.2 是 24 个工具,全部 memory 前缀,覆盖 pages、briefing、query、handoff、message、decay、lint。
本机的 memorix 1.9.1 是 20 个,多出来的是 project context、codegraph status、session 生命周期那几个。
数量差不多,方向不一样:一个往「跨 agent 协作」上长,一个往「项目上下文和代码图」上长。

中文检索这一关,我做了三组对照
这是全文我最想讲的坑。
索引表的建表语句里写着分词器:unicode61 remove_diacritics 2 tokenchars '/_-'。unicode61 的分词规则是按空格和标点切,一串连续的中文会被当成一个词。
于是就有下面这个结果。我写了三页中文笔记,直接搜:
search "构建缓存"   → 1 条(正文里正好是「Gradle 构建缓存」,整串成词)
search "白屏"       → 0 条(正文里是「渲染偶发白屏」,整串成词)
search "渲染"       → 0 条
search "skiko"      → 1 条(英文单词天然自成词)
为了确认不是我搜错,我又写了一页,故意在「白屏」两侧加空格。再搜「白屏」,这次命中。
所以规则是:中文查询必须和文中某一段连续中文完全相等,否则一条都搜不到。这不是 bug,是分词器的必然结果,但它会让人以为「记忆没写进去」。

两条实际对策。写页面时把关键术语两侧留空格,比如「遇到 白屏 时」。或者干脆用英文做键,中文留在正文里。
项目范围会掉进 scratch
我用静态 MCP 客户端调 briefing,结果全是 0。翻工具的参数说明才看到一句:静态客户端必须在每次调用时同时传 workspace 和 project。
不传就落到一个叫 scratch 的兜底项目里。你的记忆没丢,只是被记到别的抽屉里去了。
dsh 的 mcp client 是静态的,接上去之后每个调用都得带这两个参数,否则会出现「明明记了,怎么又忘了」的怪事。
记忆会自己变老
config 里有一组衰减参数,默认是 lambda 0.02、sigma 0.6、mu 0.04,冷阈值 0.20,硬删除 180 天。
翻译成能用的说法:一页笔记没人看,会慢慢变冷;过了冷阈值就能被压实,把情节压成结论;180 天后可能被真的删掉。原始观测默认永不剪,配置里是 0。
它还有一条我认为是对的:被访问过的记忆衰减得更慢。打开、搜索、点链接都算使用次数。这比「按时间清空」讲道理。
启动简报的大小我也量了。空项目 651 字符,塞三页 1,136 字符,塞十页 1,340 字符。也就是说每开一次会话,它往上下文里多放一千多字符,这个量是可以接受的。
怎么选
三条判断,按顺序问自己。
第一,你要的是「这个仓库里发生过什么」,还是「我这台机器上有多少活的线头」。前者选仓库层,AGENTS.md 加一个目录就够,不用装任何服务。后者才需要第三层。
第二,你的 agent 客户端给不给生命周期钩子。给,第三层能自动采集;不给,你得多一个手动写页面的动作,能不能坚持住要自己算。
第三,你的笔记是中文为主还是英文为主。中文为主的话,先接受检索那条限制,别指望它像搜索框一样随手就能搜到。
我自己的结论:第三层暂时只当跨机器接力的通道用,日常那些「这个坑我踩过」还是留在仓库里的 markdown,一条一条改,能看到 diff。
你那边 Agent 的记忆现在存在哪一层?欢迎评论区聊聊。