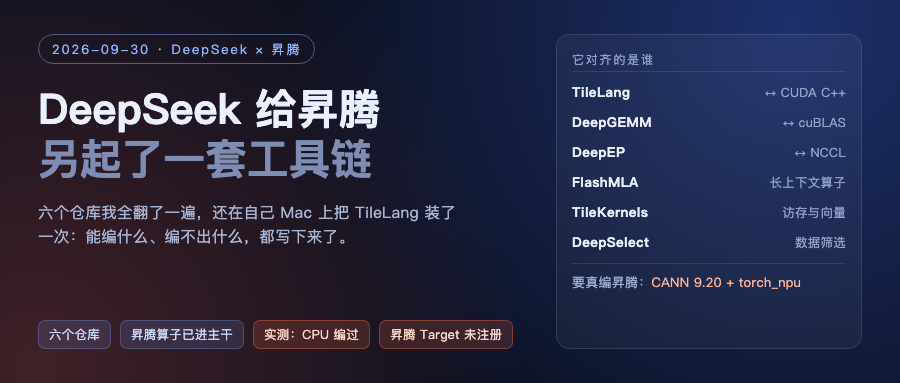
先说准确的说法
9 月 30 日上午,DeepSeek 在官方公众号上宣布:开源面向华为昇腾算力平台的基础设施组件,涵盖 TileLang 高级语言编译工具、高性能计算库、分布式通信库。官方的用词是「与之前面向英伟达平台开源的组件一一对应」。
路透当天的报道把话挑明了,说这是中国科技公司加深彼此合作、寻找英伟达生态替代路线的又一信号。
Chinese AI firm DeepSeek said on Wednesday it has partnered with Huawei Technologies to develop programming tools optimised for Huawei’s Ascend chips.彭博的标题更直接:DeepSeek 亮出的华为芯片工具,可能取代英伟达的。
我看了不少中文媒体的转述,基本都停在「对标 CUDA」这四个字上。所以这篇我不复述发布会,我去把这六个仓库翻了一遍,又在自己 Mac 上真的装了一次 TileLang,看它到底能编出什么、编不出什么。
六个仓库,我都去核了
这是官方给出的六个链接,星数和建立时间是我用 GitHub API 现取的:
| 仓库 | 星数 | 建库时间 | 语言 | 许可证 |
|---|---|---|---|---|
| tile-ai/tilelang | 8127 | 2024-10 | Python | 有 |
| deepseek-ai/FlashMLA | 13024 | 2025-02 | C++ | MIT |
| deepseek-ai/TileKernels | 1894 | 2026-04 | Python | MIT |
| deepseek-ai/DeepGEMM-Ascend | 452 | 2026-09-29 | C++ | MIT |
| deepseek-ai/DeepSelect | 449 | 2026-09-09 | Cuda | MIT |
| deepseek-ai/DeepEP-Ascend | 200 | 2026-09-30 | C++ | 没声明 |
注意最后一行。六个仓库里,只有 DeepEP-Ascend 没有声明许可证,其余五个都是 MIT。对做企业选型的人来说,这一格值得你自己再去确认一次。
还有一件事值得说清:「昇腾支持」不全是新开的仓库。我去翻了原仓库的提交记录:
FlashMLA     2026-09-30  Open-source release for Ascend 950 (2026.09.30) (#229)
DeepSelect   2026-09-30  Add Kernels for Huawei Ascend NPU (#23)
TileKernels  2026-09-30  Release tile-kernels v2.0.0
FlashMLA 和 DeepSelect 是把昇腾算子直接合进了主干,只有 DeepGEMM 和 DeepEP 因为改动大另起了 -Ascend 两个仓库。所以「一一对应」不是宣传话,是能对上的。
它对应 CUDA 生态的哪个位置
我把这六个东西按我的理解对了一遍:
- TileLang,对应写算子的那一层(CUDA C++、Triton 所在的位置)
- DeepGEMM,对应矩阵乘,就是 cuBLAS 那块
- DeepEP,对应跨卡通信,NCCL 那块
- FlashMLA,长上下文和稀疏注意力的算子
- TileKernels,常规向量计算和访存算子
- DeepSelect,数据筛选
官方对 TileLang 的说法是:相对 CUDA 编程更简单,能显著提高开发效率、简化代码逻辑,同时不损失硬件性能。它还补了一句关键的:TileLang 这条路先在英伟达平台上验证过了,目前已承载 DeepSeek V4 系列模型训练中大部分算子的实现。
这句话的分量比跑分大。意思是他们不是在昇腾上重新发明一套东西,而是把自己在英伟达上已经用顺手的那套搬过去。
官方给的数字
性能数据来自官方和华为那篇供稿,我原样转述,口径写在后面:
- 通信:DeepEP 的 Dispatch 实现 375 GB/s、Combine 347 GB/s,官方说接近硬件上限
- 组网:昇腾 950 的 SuperPoD Flex 加 UBL128 方案,128 卡单层 3.2 Tbps 的 scale-up、256K 卡两层 scale-out
- 推理:EP32、offline 模式下跑 DeepSeek-V4.1-Flash,TPOT=5ms 时每卡输出 2469 tokens/s,TPOT=10ms 时每卡 5102 tokens/s(128K 上下文,Dspark 投机接受率 0.85)
一句提醒:这些是厂商口径,测试条件是 offline 推理,不含服务调度和框架负载均衡的影响。我这边没有昇腾硬件,跑不了这个 benchmark,只能告诉你它是这么说的。
我在自己 Mac 上试了 TileLang
光看新闻没意思,我去装了它。
uv venv --python 3.12 /tmp/tl
uv pip install --python /tmp/tl/bin/python tilelang
# tilelang 0.1.15 | torch 2.14.1
装得挺顺,macOS 的 arm64 wheel 是有的。然后我写了个最小的算子,128×128 的逐元素相加:
@T.prim_func
def main(A: T.Tensor((M, N), dtype), B: T.Tensor((M, N), dtype), C: T.Tensor((M, N), dtype)):
    with T.Kernel(T.ceildiv(N, block), T.ceildiv(M, block), threads=128) as (bx, by):
        for i, j in T.Parallel(block, block):
            C[by * block + i, bx * block + j] = A[by * block + i, bx * block + j] + B[by * block + i, bx * block + j]
然后分别往三个目标编,结果很整齐:
目标 = c(CPU)    ✅ 编译通过,生成 448 字符 C 源码
                     实跑结果与参考一致: True
目标 = cuda        ❌ module 'tilelang.cuda._ffi_api' has no attribute
                     'AnnotateDeviceBoundTmaCopies'
目标 = ascend      ❌ AssertionError: Target ascend is not supported

昇腾那个报错我不服气,绕过它的检测器直接塞 Target 字典进去,报的是:
ValueError: Target kind "ascend" is not defined.
Target creation from config dict failed: {"kind": "ascend"}
翻源码就明白了。它的昇腾可用性检测是这么写的:要求 torch.npu.is_available() 为真,也就是必须真的挂着昇腾运行时。
包里其实带了昇腾的 codegen 源码和模板(src/ascend、src/tl_templates/ascend/*.h,还有一个 npu 交换层的扩展),但这版 wheel 的运行时里没有注册昇腾目标。所以:
我这台 Mac 能证明 TileLang 是个真编译器(CPU 目标编得出、跑得对),但证明不了昇腾那条路。
要真编昇腾,DeepGEMM-Ascend 的 README 写得很死:
Requirements
- HUAWEI Ascend NPU (developed and validated on the Ascend 950 series)
- CANN 9.20 toolkit providing bin/bisheng, bin/ld.lld
- Torch NPU package torch_npu
- Python 3.10 or higher
pip install . --no-build-isolation,然后你还需要那张卡。我这条路上,缺的是最后一行。
这件事对做客户端的你意味着什么
如果你是写应用的(比如我手上那个 AI Chat 客户端),短期什么都不会变:API 价格、响应延迟,照旧。
中期真正值得关注的是「供给」两个字。如果同一份模型代码少改几行就能跑在昇腾上,国产算力的可用比例就会往上走,推理成本那条下行曲线会更稳一点。这跟你的关系不是今天能省钱,而是明年报价单上多一个变量。
还有一层更远的影响:TileLang 这套「高级语言写算子、还不丢性能」如果铺开,端侧小模型的算子适配成本也会降。做端侧推理的人应该盯着它,而不是盯着跑分。
我的判断
第一,这次开源真正难的部分不是把算子写出来,而是让开发者不为硬件重写代码。六个仓库、一一对应的说法,就是把这件事讲成了一句话。
但我实测里那个 Target kind "ascend" is not defined 也说明了另一面:这条路目前的另一头拴在 CANN 9.20 这种强版本依赖上,换个平台、换个版本,链接不上的地方会以很直接的方式报给你。
第二,方向是清楚的。英伟达的位置从来不只是芯片快,而是 CUDA 二十年攒下来的那套东西:库、工具、文档、人的习惯。DeepSeek 和华为这次动的就是这个位置,而且是拿已经在自家训练里跑过的语言去动,不是从零另起。
第三,边界要标清楚。我没有昇腾硬件,这篇文章里的每个性能数字都来自官方口径;我亲自验证的只有三件事:六个仓库的真实状态、昇腾算子确实合进了原仓库主干、以及在那台 Mac 上 TileLang 能编什么、不能编什么。
参考资料:
- DeepSeek 官方开源公告(经 IT之家转述):https://www.ithome.com/1/008/604.htm
- 华为供稿(含性能与组网数据):https://www.qbitai.com/2026/09/499263.html
- 路透报道:https://www.reuters.com/world/asia-pacific/deepseek-partners-with-huawei-develop-chip-programming-tools-reducing-reliance-2026-09-30/
- DeepGEMM-Ascend 仓库:https://github.com/deepseek-ai/DeepGEMM-Ascend
- DeepEP-Ascend 仓库:https://github.com/deepseek-ai/DeepEP-Ascend
- TileLang:https://github.com/tile-ai/tilelang
验证边界:仓库星数、建立时间、许可证取自 GitHub API 实测;昇腾提交记录取自各仓库 commit 历史;TileLang 的安装与三种目标的编译结果在本机实跑(macOS arm64,tilelang 0.1.15,torch 2.14.1);性能与带宽数字均为官方口径,本机无昇腾硬件,未做任何 benchmark。