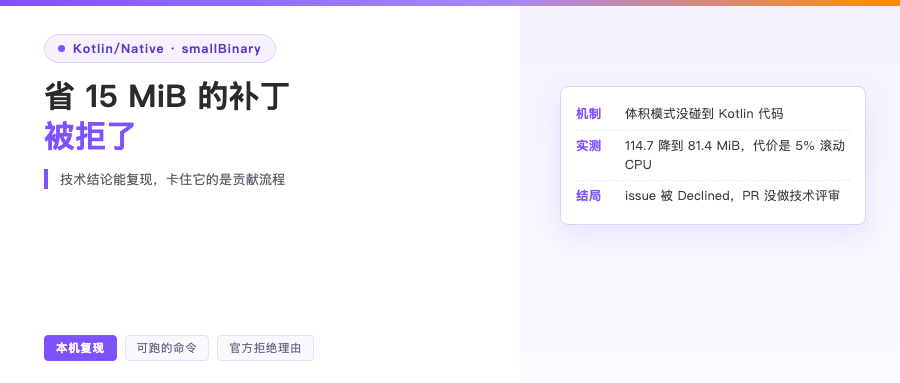
一个工程师给自己的 iOS 包做体积优化,发现只要给编译器加一个 flag,包体就能小 15 MiB。他写了 issue,附上公开项目的复现和相关设备数据,当晚开了 pull request。
第二天早上,PR 被关掉,没有技术评审。
关 PR 的理由是:不接受低投入的 AI 生成贡献。这句话值多少,得先把技术部分看完才有感觉。
他发现的东西:小二进制模式没碰到 Kotlin 代码
事情的主角是 Kotlin/Native 的 smallBinary,2.2.20 起提供的实验性选项,作用是把 IR 管线的优化级别切到 Oz,同时不再强制内联运行时热路径。听起来该省的都省了。
但最后一步代码生成,Kotlin/Native 走的还是 clang -cc1 ... -O3,这个值就写在工具链的 konan.properties 里,键是 clangOptFlags.ios_arm64。
而 LLVM 那个能去掉重复机器码的 MachineOutliner 在 AArch64 上的默认策略是,只对带 minsize 属性的函数生效。
两条一叠:IR 层是体积模式,机器码层还是性能模式,而 Kotlin 生成的函数不带 minsize。结果就是 MachineOutliner 扫过一遍,一个 Kotlin 函数都没碰。
他在 issue 里给了两组数字。最终 bitcode 的 33,881 个函数定义里,只有 55 个带 minsize,全是运行时冷路径。他们的 app 里,装着 33 MB Kotlin 代码的那个 object 只有 11 个 outline 助手,旁边预编译的 Skia 对象有 4,459 个。
我自己跑了一遍
这种事不该只看别人的数。本机有 Kotlin/Native 2.4.0,我写了一小段接口派发密集的代码,300 个函数,同一个源文件编译三次,都用 -opt 和 -Xbinary=smallBinary=true。

机制这部分完整复现了。默认只有 9 个 outline 助手,说明这个 pass 确实在跳过 Kotlin 代码;一个 konan.properties 覆盖加上去,助手数量到上千,体积同步往下走。绝对体积只降了 5% 到 9%,因为我这个示例工程太小,而他那份 Kotlin object 有几十 MB。
本机 konan.properties 里也确实写着 clangOptFlags.macos_arm64 = -O3 和 llvmInlineThreshold = 100,他立论的两个前提都对得上。
省下来的体积,和账的另一面
他的 app 是 Compose Multiplatform 的 iOS 构建,未签名归档 114.7 MiB(同一 commit,Kotlin 2.4.10,Xcode 26.5)。
smallBinary + latin1Strings         114.7 → 101.7 MiB
再强制开 outliner                     → 86.9 MiB
再加内联阈值 5                        → 81.4 MiB
第三步那 81.4 MiB 值得多看一句:他用改过编译器的版本(给每个 Kotlin 函数打上 minsize)做出 81.3 MiB,两者只差 0.1 MiB。也就是说这个收益里绝大部分来自少内联,不改编译器也能拿到。
代价他也写清楚了。iPhone 13 上做 23 秒程序化滚动,CPU 从 8.48 秒涨到 8.94 秒,涨 5.4%,单帧卡顿从 18 次变成 27 次;iPhone X 上 CPU 涨 6.5%。启动时间没变化。
更反直觉的一条是下载体积。整个可执行文件 gzip 后从 20.42 MB 变成 20.05 MB,只动了 0.37 MB。未签名包体掉了 14.8 MiB,压缩后几乎没动,因为被去掉的重复正是压缩算法最喜欢吃的东西。
另外,框架的代码生成时间从 2 分钟涨到 6 分钟;崩溃栈顶会多一层 OUTLINED_FUNCTION_n,不过 lldb 还能回溯到真正的调用者,他拿 Kotlin 异常和 SIGSEGV 在两种构建上试过,逻辑栈一致。
他自己的处境是金融类 app,结论是宁愿滚动顺滑,也不要省那 15 MiB。两个 binary option 在评审中,outliner 这条等自家最重的页面做完设备测试再说。
然后 JetBrains 关了他的 PR
技术部分说完了,轮到那句拒绝。
We don’t accept low-effort AI-generated contributions that shift the burden of understanding, verifying, and fixing the proposed changes onto maintainers.
翻译过来是,不接受低投入的 AI 生成贡献,这类提交把理解、验证、修复的负担转移给了维护者。后面还有一句:用 AI 工具没问题,但贡献者要投入自己的工程努力,对提交的质量和正确性负责。
作者在文里的复盘很坦率。他承认自己借了 AI 工具准备 PR,在团队还没看 issue 之前就把 PR 开了,一小时后又重写了一遍。从他的角度,这是一次着急;从维护者角度,这就是每天被淹没的那种顺手提交。
不过他也留了一句边界:PR 被关,不等于技术结论被推翻。那些数字用一个 flag 加现成编译器就能重现,公开的 KotlinConf app 也给了别人独立核对的路。顺手提一句,那个公开 app 的 Kotlin object 从 14.88 MB 降到 8.33 MB。
issue 那边的状态现在是 Declined,创建于 10 月 7 日,第二天更新。
写 Kotlin/Native 的人现在能做什么
如果你的项目里有 iOS framework,这三件事按顺序来。
先开 smallBinary 和 latin1Strings 这两个 binary option,stock 编译器就能用,都是实验性选项,每次升级 Kotlin 记得重测。他那边这一步拿了 13 MiB。
再想往下压,就是 konan.properties 覆盖这条路:强制 outliner、往下压内联阈值。它有收益,但属于未公开用法,官方公开的是 -Xllvm-module-passes 和 -Xllvm-lto-passes,而且还有 KT-69212 说明现在没法直接禁用某个 pass。
这类覆盖有个隐患,万一某个版本改了属性名,它会静默失效,所以要在 CI 里挂一个体积校验。
最后,发布前一定做设备性能测试。这条优化是用 CPU 换体积,他实测的滚动开销就是 5% 往上。
顺带几个他也测过、结果不一样的项:
- 有个 vendor 的 Swift package 把一个用不上的 4.9 MiB OpenSSL 框架打了进来,可以用
otool -L配合nm查 - Skiko 带的 ICU 数据 6.3 MB,他裁过一版,长按输入框直接崩了,这条路他停在那里
material-icons-extended声明在多个模块里但一个字节都没进包,删掉只省构建时间@Preview函数在 release 里本来就被剥掉了- LLVM 的全局函数合并那个著名的体积 pass,在他这套配置下反而让 Kotlin object 大了 0.44 MB
最后
这件事有意思的地方不在那 15 MiB。一个可复现的性能问题、一个公开的复现项目、一组设备上的实测数据,凑齐这些之后,卡住它的不是技术争议,是贡献流程里的信任成本。
对写代码的人是提醒:issue 先让维护者评估,别急着开 PR。对维护者是另一道题:AI 把 PR 的产出成本压到近乎为零,评审成本却一点没降,这条线会有更多项目划出来。
你会为了省 15 MiB 接受 5% 的滚动开销吗,评论区聊聊。
参考:
- Mo Yaver 的实测长文 https://medium.com/@mhammadjaber00/kotlin-natives-smallbinary-never-runs-llvm-s-outliner-on-kotlin-code-f457d0fbb6d2
- 他提的 issue KT-90068 https://youtrack.jetbrains.com/issue/KT-90068
- 被关闭的 PR #8802 https://github.com/JetBrains/kotlin/pull/8802
- Kotlin 2.2.20 发布说明(smallBinary 与 latin1Strings)https://kotlinlang.org/docs/whatsnew2220.html
- Kotlin/Native binary options 文档 https://kotlinlang.org/docs/native-binary-options.html
- 自定义 LLVM 优化 pass 的说明 https://kotlinlang.org/docs/native-llvm-passes.html