跑分是真猛
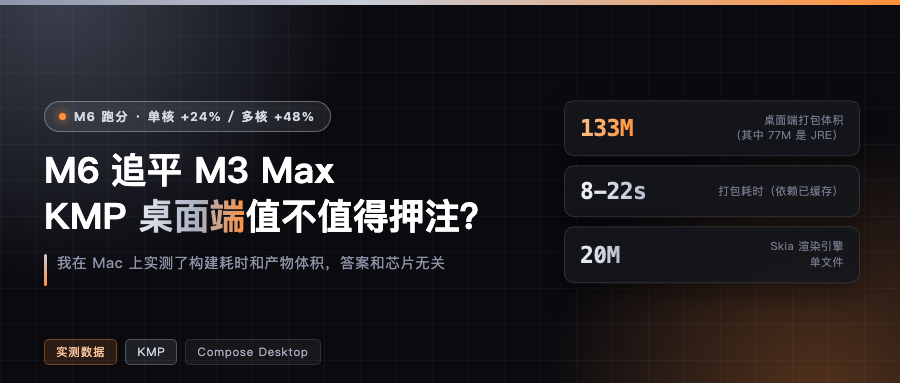
苹果 M6 的跑分这两天陆续曝光。单核比 M4 那款高约 24%,多核高约 48%,多核直接追平了 M3 Max——一颗中端定位的芯片,多核打平上一代旗舰,确实挺夸张。
GPU 那边,12 核在 Geekbench 上跑出单核 4071、多核 22783,比 M5 高 20% 左右。
然后我就看到有人开始讨论:芯片都这么快了,是不是可以把桌面端也搞起来?
我拿自己手上的项目试了试。结论有点扫兴:这件事基本跟芯片跑分没关系。
我在机器上跑了什么
本机是 Mac mini,M4,10 核,16G 内存。项目是个 KMP + Compose Multiplatform 的 AI Chat 客户端,shared 放共享逻辑,desktopApp 是桌面入口。
打包就一条命令:
./gradlew :desktopApp:createDistributable
跑了两遍,第一遍 22 秒,第二遍 8 秒。都挺快——但这两次依赖早下好了,代码也没怎么动。真正的第一次冷构建(下依赖、编 Kotlin、生成运行时镜像)是要按分钟算的。
快是快,不过这不是重点。重点是最后一个数字:
$ du -sh lange.aichat.app
133M
一百三十三兆,一个聊天客户端。
拆开看才有意思:
| 目录 | 大小 | 里面是什么 |
|---|---|---|
| Contents/runtime | 77M | 打包进去的 JRE |
| ├ lib/modules | 52M | JRE 核心模块 |
| └ libjvm.dylib | 17M | JVM 本体 |
| Contents/app | 55M | 应用和依赖 |
| ├ libskiko-macos-arm64.dylib | 20M | Skia 渲染引擎 |
| ├ skiko-awt-runtime | 8.9M | Skiko 的 JVM 绑定 |
| ├ material3-desktop | 4.4M | |
| ├ foundation-desktop | 4.4M | |
| └ ui-desktop / runtime / kotlin-stdlib | 3.3 / 1.9 / 1.8M |
77M 是 JVM 本身,再加 20M 的 Skia,光是让程序能跑起来的底座就 97M。你自己写的那部分,可能就几百 K。而且那 77M 已经是 jlink 裁过一遍的结果了,不是原始大小。
所以账很清楚:Compose Desktop 写起来舒服,但分发成本摆在那。除非把 JVM 这个前提换掉(GraalVM native-image 那条路),否则百兆上下就是常态。
M6 快这么多,用处到底在哪
编译。Kotlin 编译、Gradle 并行任务、native 链接,这些都是吃多核的活,多核加 48% 能实打实缩短构建时间。
我顺手把同一个仓库里的另一个 target 也测了:
./gradlew :app:webApp:wasmJsBrowserDistribution
→ BUILD SUCCESSFUL in 4m 10s
4 分 10 秒,50 个任务全跑了一遍,CPU 和内存吃得满满的。天天要跑好几次构建的人,对这种多核提升感受最直接。
那最终用户呢?
一个聊天客户端,用户能感觉到的瓶颈是这些:冷启动——JVM 加载加 Compose 初始化,吃的是单核和 IO,多核帮不上多少;滚动和动画——看 Skia 的,GPU 那 20% 对 2D 界面来说过剩;首屏——看网络。
M6 再快一半,用户也不会觉得你的应用变快了。
那到底该不该做桌面端
我自己是这么看的。
已经有 KMP 项目、想多覆盖一个平台的,可以直接加。shared 逻辑本来就在那,无非多写一个入口。做内部工具、开发者工具的也能加,反正只给自己团队装,没人在乎包多大。
真正值得单独立项的是另一类需求:要在本地读写文件、要开多窗口常驻后台、要在本机跑模型。这些是桌面能做、手机做不了的。这种场景下 133M 根本不算事——用户装的是工具,不是玩具。
反过来,面向普通消费者的轻量小工具得谨慎。用户不会为一个查天气的小应用下 133M。对冷启动有硬要求的也一样,JVM 那条冷启动曲线绕不过去,除非上 GraalVM。
顺带一提,Compose Multiplatform 1.13 已经在做 AppCDS 和 AOT 了(1.13.0-alpha01 的更新里写了"显著加快应用启动")。如果你现在正因为启动慢犹豫,可以再等一两个版本。
最后
M6 很好。构建能快一截,这点对天天敲代码的人是真实收益。
但它改变不了桌面端的取舍。卡人的是包体积和冷启动,这两样芯片管不着。如果你的动机是"吃到新硬件红利",那可能看错地方了——桌面端真正的红利在打包技术上(jlink、AppCDS、GraalVM),不在 CPU 跑分上。
如果你已经在做 KMP,桌面端其实是最便宜的那一端,shared 已经写好了,加个入口就多一个平台。这个理由跟芯片无关,但我觉得比跑分实在。
你会给项目加桌面端吗?能接受多大的包?评论区聊聊。
测试环境:Mac mini(Apple M4,10 核,16GB),macOS 27.0,JDK 21.0.10,Kotlin 2.4.0 + Compose Multiplatform 1.11.x。M6 跑分来自 Geekbench 曝光成绩,及 cnBeta、Notebookcheck、凤凰网科技等公开报道。