GitHub 上有个仓库,cloudflare/security-audit-skill,四万四千多星。它的作用是让 coding agent 变成安全审计员。只读 README 的话,你会以为这就是又一个 prompt 合集,塞一堆攻击手法让模型照着查。
我把整个仓库拉下来数了一遍,发现不是这样。
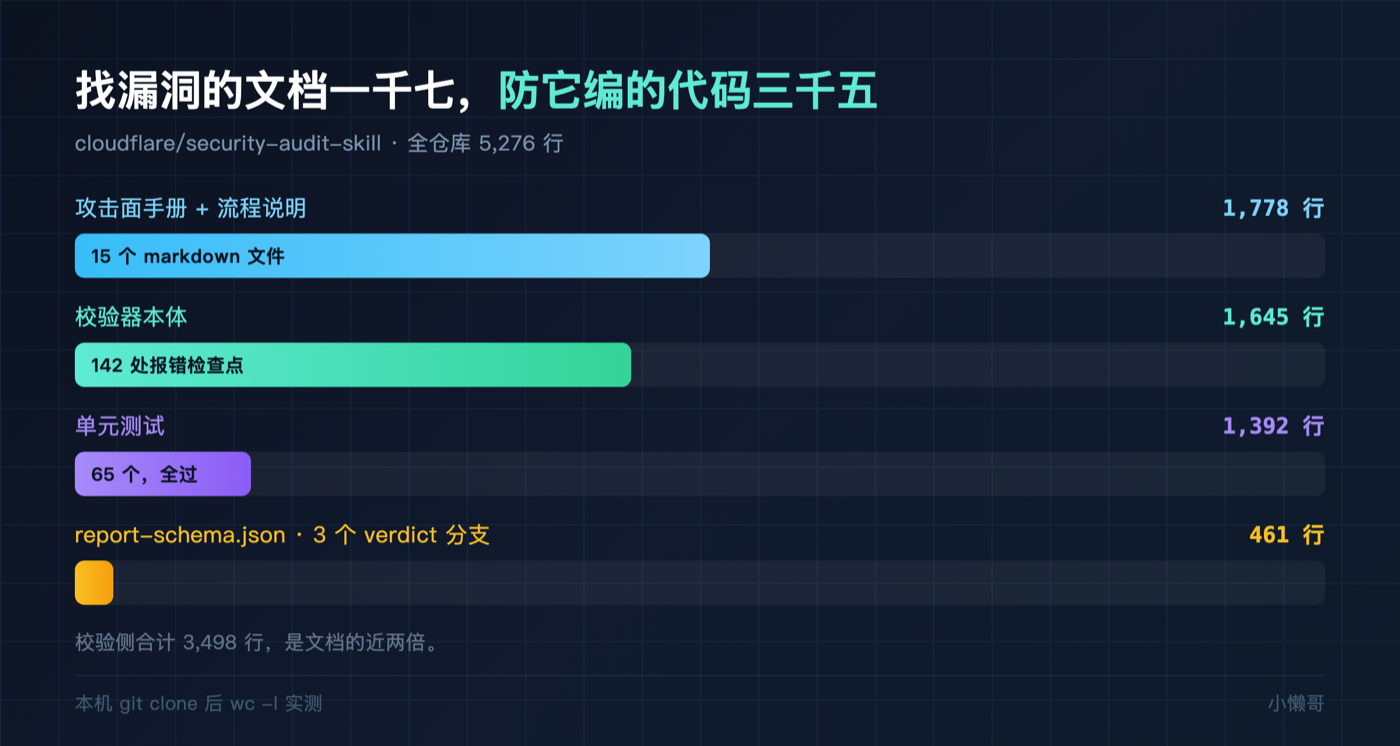
文档一共 1778 行,十四个攻击面分类手册加上流程说明。校验器本体 1645 行,两个校验器里有一百四十二处明确的报错检查点。再加上一千三百九十二行测试和四百六十一行 schema,校验侧合计三千四百九十八行。
找漏洞的文档一千七,防它胡说八道的代码三千五。
官方的漏斗
Cloudflare 博客里那篇讲他们自己漏洞挖掘 harness 的文章,给了一组数。
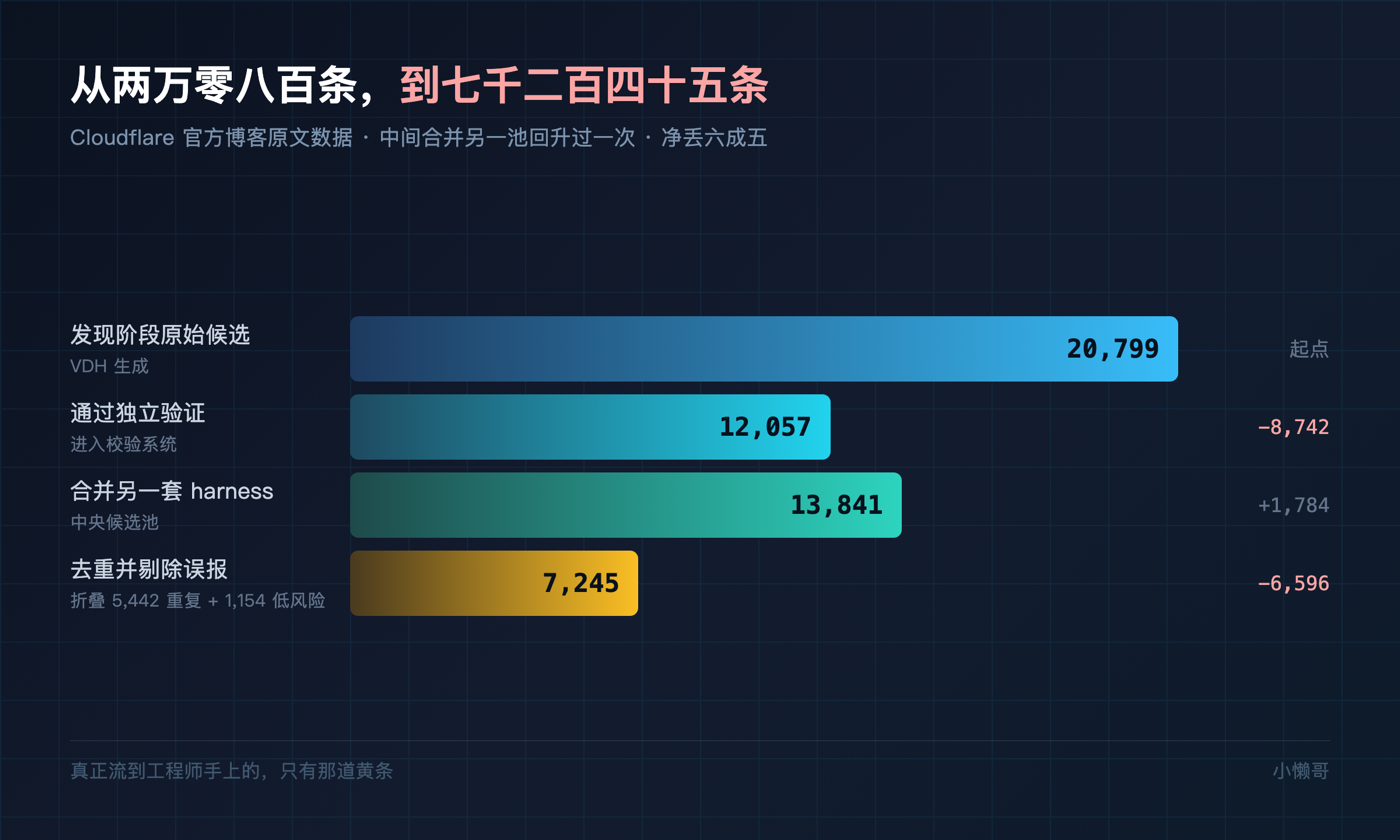
发现阶段生成两万零七百九十九条原始候选。经过独立验证,活下来一万二千零五十七条。跟另一个 harness 的结果合并,总池一万三千八百四十一。去重折叠掉五千四百四十二条,还有一千一百五十四条被判定为仓库搞错或者风险不足,打回系统。
到工程师手上的,七千二百四十五条。从两万零八百到七千二,丢掉六成五。
他们自己在文章里写得很直白,这个 harness 的核心指标不是召回率,是让未确认的东西出现在真人面前的次数尽量接近零。
原话是,架构本身必须是一个不肯停的过滤漏斗。
这句话我信。
两个模型互查
文章里有句话我反复看了几遍。
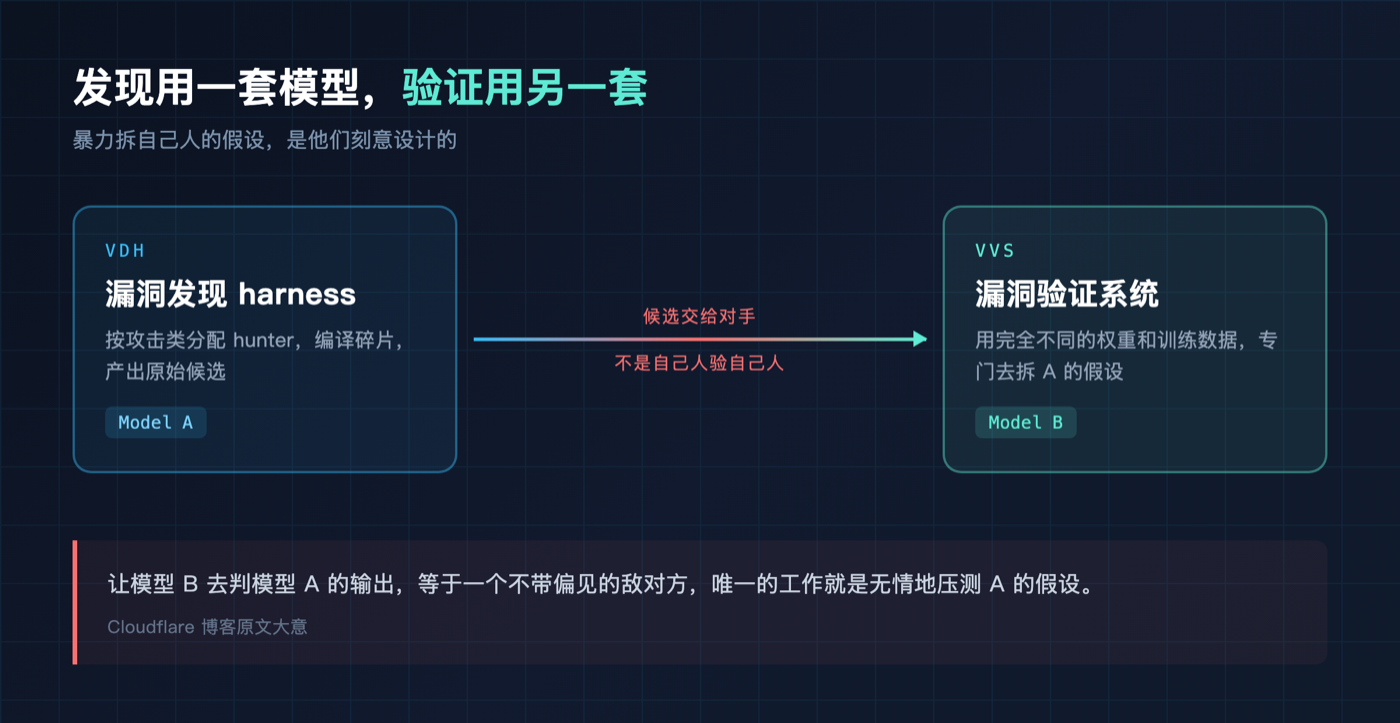
他们用一套模型跑发现,用完全不同的另一套模型跑验证。理由写得很清楚,如果让模型 B 去判模型 A 的输出,那么 B 会用完全不同的权重和训练数据来看,等于一个不带偏见的敌对方,专门去拆 A 的假设。
同一篇文章里还有一句,我拿来当这条推送的标题都行。当你把不同的模型指向同一个目标时,它们各自找到的 bug 比例是不一样的。
还有一个被埋在正文里的数。他们自己的测试里,单次运行找到的漏洞,大约是重复运行总量的一半。
一半。
这是他们自己主动说的。
我拿它的校验器做了个实验
光看文档不算数,得让代码跑起来。
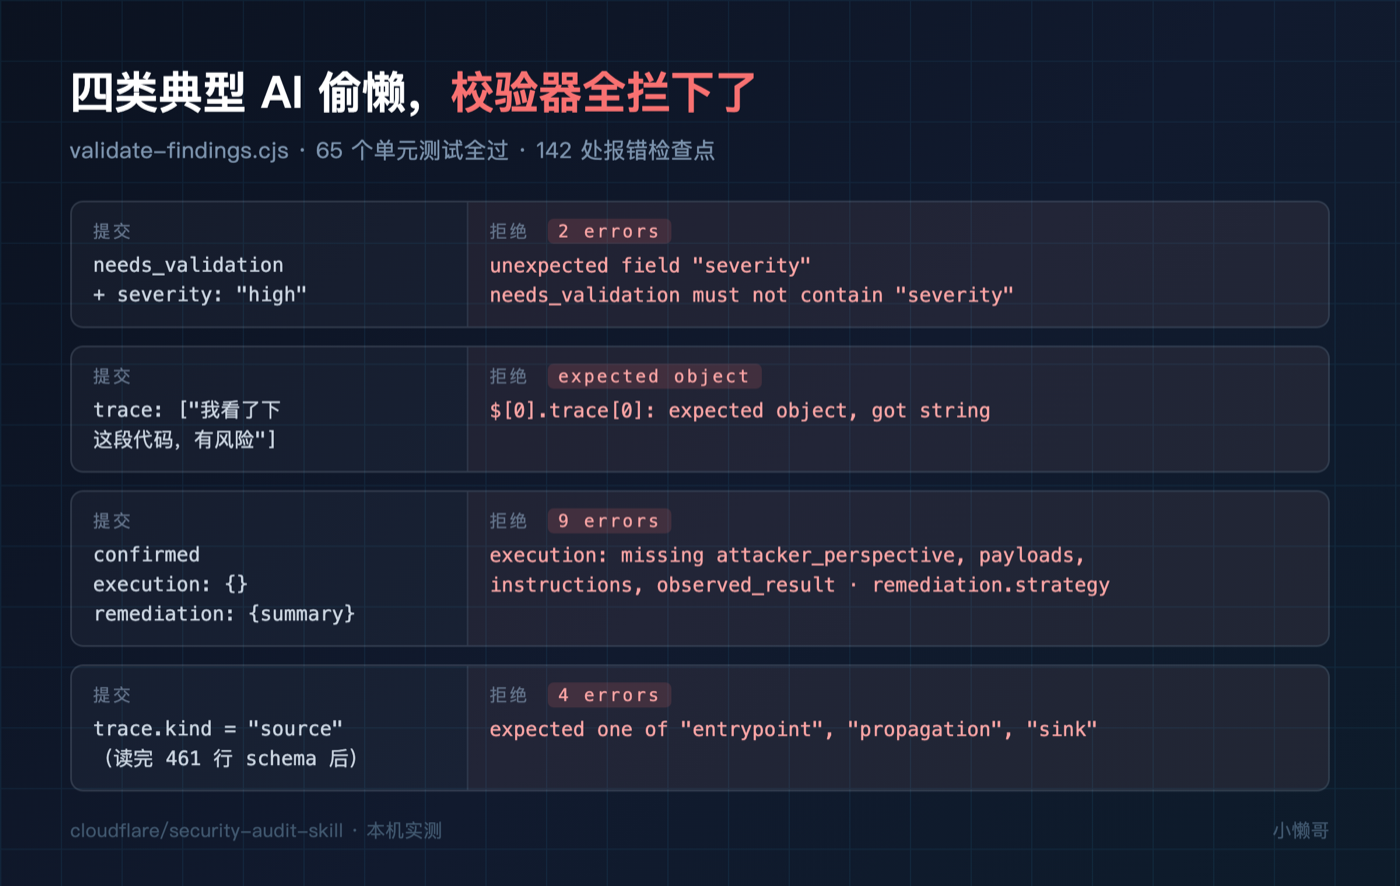
它的自带测试两个校验器合计 65 个,全过零失败。测的东西很细,拒绝 Unicode 格式控制符、拒绝 FIFO 不阻塞、拒绝符号链接不跟随、拒绝超嵌套不抛栈、在受限内存堆下工作。
然后我自己造数据去撞它。
按 AI 最常见的偷懒方式写一条 needs_validation 记录,顺手加个 severity。校验器回了两条错,一条说这个字段不该存在,一条说这类记录不允许包含 severity。同一件事被规则从两个方向各拦一次。
把 trace 写成一句散文,它直接告诉我,期望对象,收到字符串。
最打脸的是第一次,我以为自己读完了 schema,结果连合法样例都写不对,错了四处。trace 的 kind 只能是 entrypoint、propagation、sink,我写了 source。
一个有耐心读完 461 行 schema 的 agent,第一次照样写错四处。这不是苛刻,是糊弄不过去。
它交上来的是一个空数组
校验器只是外围。真正的问题是,让 agent 按这套标准去审一个文件,它会交出什么。
我挑了自己能做对照的目标,就是那个 773 行的校验器本体。给它的指令只有一条,候选必须同时给出六个要素,少一个就丢掉,不要凑数。
它跑了两分半,交回来一个空数组。
候选零条。
但它没有就这么结束。它又列了十条“看着像漏洞”的点,逐条说明为什么不算。我挑几条你能对上的:
终端注入。校验失败时会把用户路径打到 stderr,看着像 ANSI 转义注入。它查到第 98 行,每条消息都过一遍转义函数,覆盖控制符、格式符、代理对。它还指出 safeQuote 在转义前会截到 256 个字符,截断可能把代理对劈成半个,而半个代理对本身也在转义范围内。
资源耗尽。5 MiB 上限查了两次,一次 fstat 看文件大小,一次读的时候按字节计数,所以读取途中文件变大也躲不过。深度 64 层、数组 1000 项,同样在原始文本和解析后各查一遍。
符号链接和 FIFO。打开用的是 O_NOFOLLOW 加 O_NONBLOCK,平台没有这两个常量就直接拒绝运行,不降级。之后 fstat 的是文件描述符不是路径,不存在开了再重开的竞态。
还有两条它一句话带过。ReDoS 那个正则的 pattern 来自随包发布的 schema,不是 findings.json,攻击者控制的是被匹配的字符串。原型污染那条,所有攻击者控制的键取值前都过了 hasOwn。
十条里没有一条站得住。
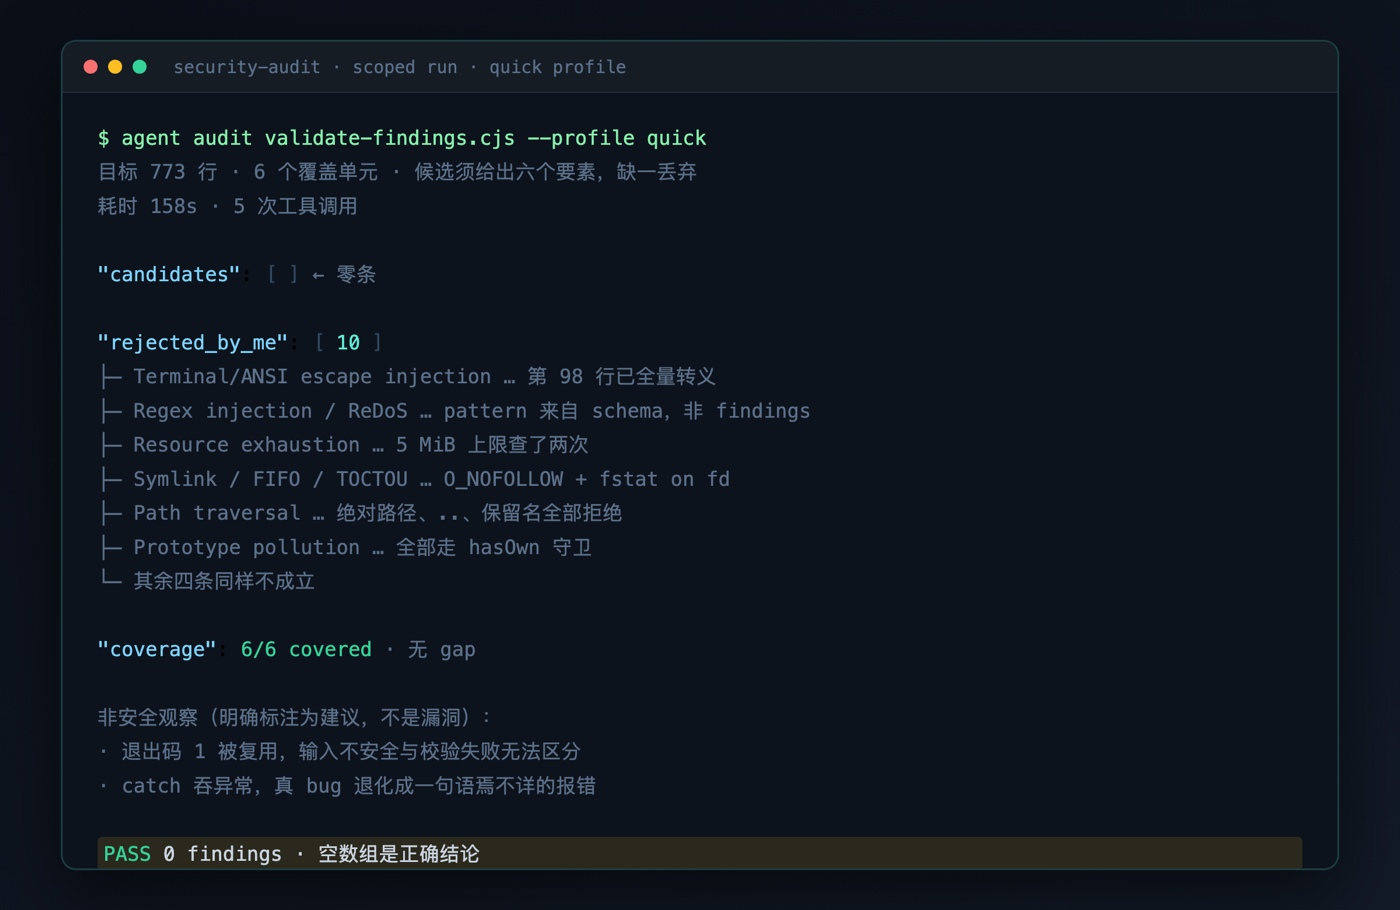
收尾它还给了份非安全观察,说这个文件退出码 1 被复用了,输入不安全和校验失败都是 1,调用方没法区分;catch 把异常吞掉了,真正的 bug 会变成一句语焉不详的错误。这些它都明确标注成工程建议,不是漏洞。
空结果为什么比有结果更有说服力
一个被要求给出证据的 agent,遇到无懈可击的代码,会交白卷,而不是编一条出来。
这话不能说过头。我只有一个样本,而且这段代码本身就是安全团队写的。它证明不了这套流程在真有毒的代码上也能找到东西。
但它证明了另一半。这套流程能挡住「看起来像问题」的东西被包装成漏洞。
而后者才是这类工具真正难的地方。找东西不难,模型天生爱说话。难的是让它在该闭嘴的时候闭嘴。
他们踩过的三个墙
博客里还有一段讲从本地 skill 走到全舰队扫描时撞的墙。
第一堵是上下文耗尽,跑一小时窗口就满,模型开始吃自己的记忆,一早上追的 bug 转身就忘。解法写得很硬,每个 agent 的活切极细,上下文压在窗口总量的 25% 以下。填满就开始幻觉,这句是原文。
第二堵是速度,得并行开。他们发现有些模型不太会主动 fork 兄弟 agent,于是加了个请求机制,撞到范围外但有价值的路径可以开分身,这个动作占全部任务的 9% 到 20%。
第三堵最朴素,一次限流或者连接抖动,几小时的工作没了。
跟验证这件事是同一个战场
上个月 Flutter 团队那篇官方文章说,代码生成本身早就不是瓶颈,验证才是。
上周写 Compose 的时候,我看到的是 JetBrains 把运行中的应用整个开放给 agent,让它自己改、自己重载、自己截图确认。
Cloudflare 这个走的是第三条。它不去优化验证的速度,而是把验证本身做成一道过不去的闸门。
三种解法的共同点很清楚。真正稀缺的不是让 AI 干活的能力,是判断它干得对不对的能力。而后面这件事,目前主流做法还是把它交回给另一个 AI。
你可以怎么用
这个 skill 能直接装,README 给的是 npx skills add,装到任何 agent 的 skill 目录都能用,前提是你的 agent 支持并行子任务。
有一条要注意。它要求操作系统级沙箱,禁外网、空环境、只读目标、只能写自己的临时目录、明确资源上限。这条不满足,skill 会拒绝执行目标代码,所有结论降级为待验证。
我原本想在自己的 dsh 里跑完整六阶段,卡在凭证上,headless 模式拿不到 API key。后来改用独立 agent 跑发现段,验证段因为候选为零没启动。所以这篇的数字分三类来源,漏斗那组来自 Cloudflare 博客原文,测试和校验实验是我本机跑的,审计结果来自一个独立 agent。
你们团队的 code review,现在是人在看 AI 写的代码,还是 AI 在看你写的代码?说说看。