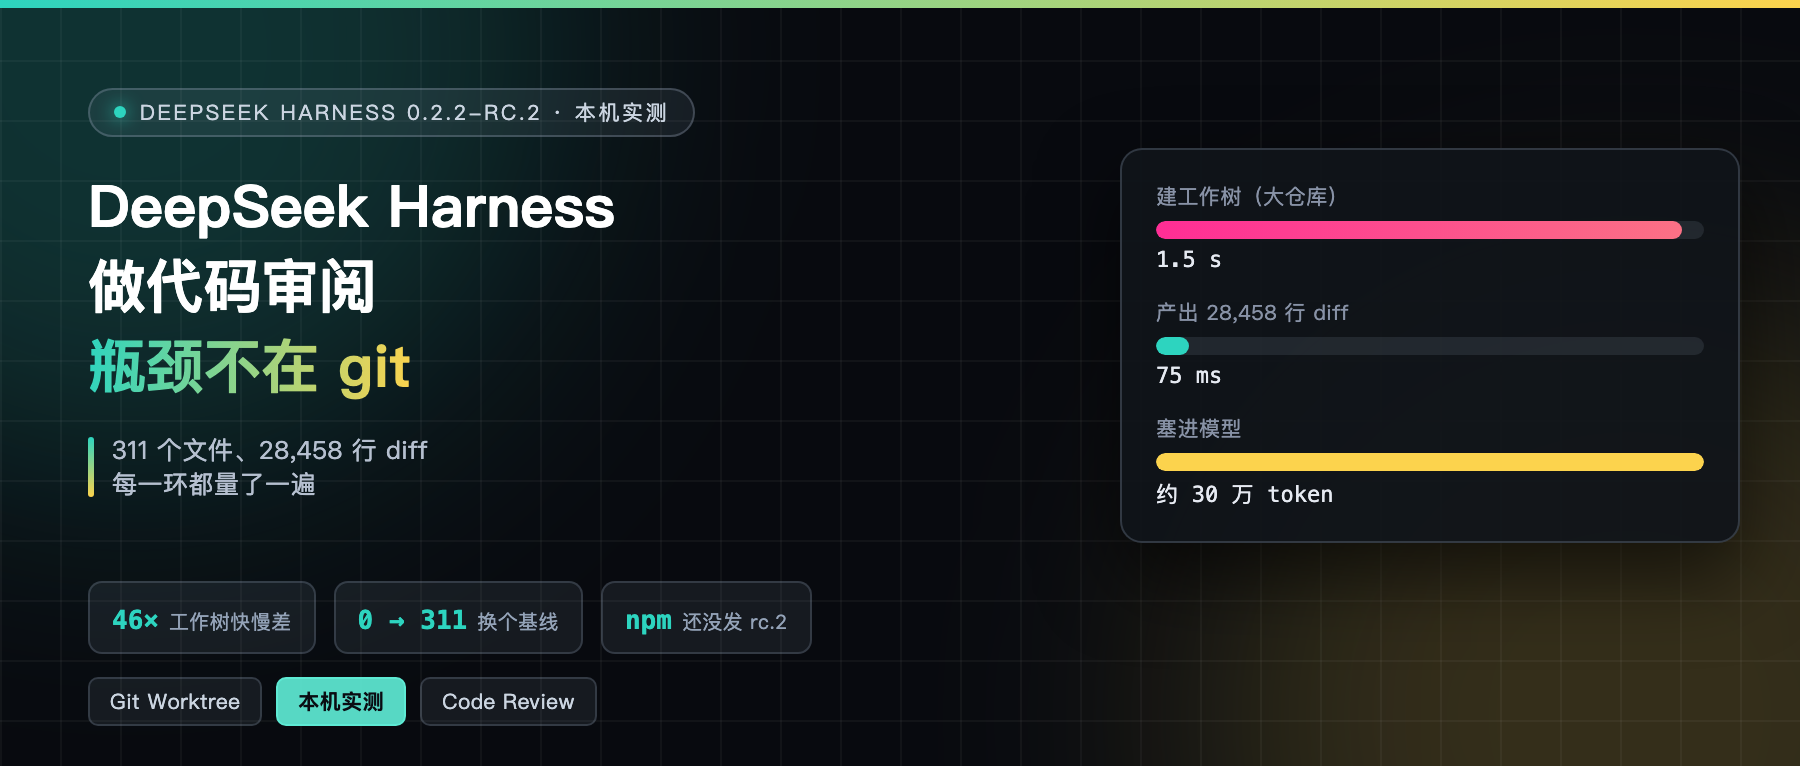
DeepSeek Harness 发了 0.2.2-rc.2,其中一条写着「Git Worktree 支持按分支、提交和文件类型审阅改动」。
我当晚就去升,结果 npm 上根本没有这个版本。
三个地方三个版本号
GitHub Releases 上是 dsh-v0.2.2-rc.2,11 日 11:33 发的。我去装,npm 报 notarget。
查了一下 dist-tags,latest 和 next 都还指着 0.2.2-rc.1。
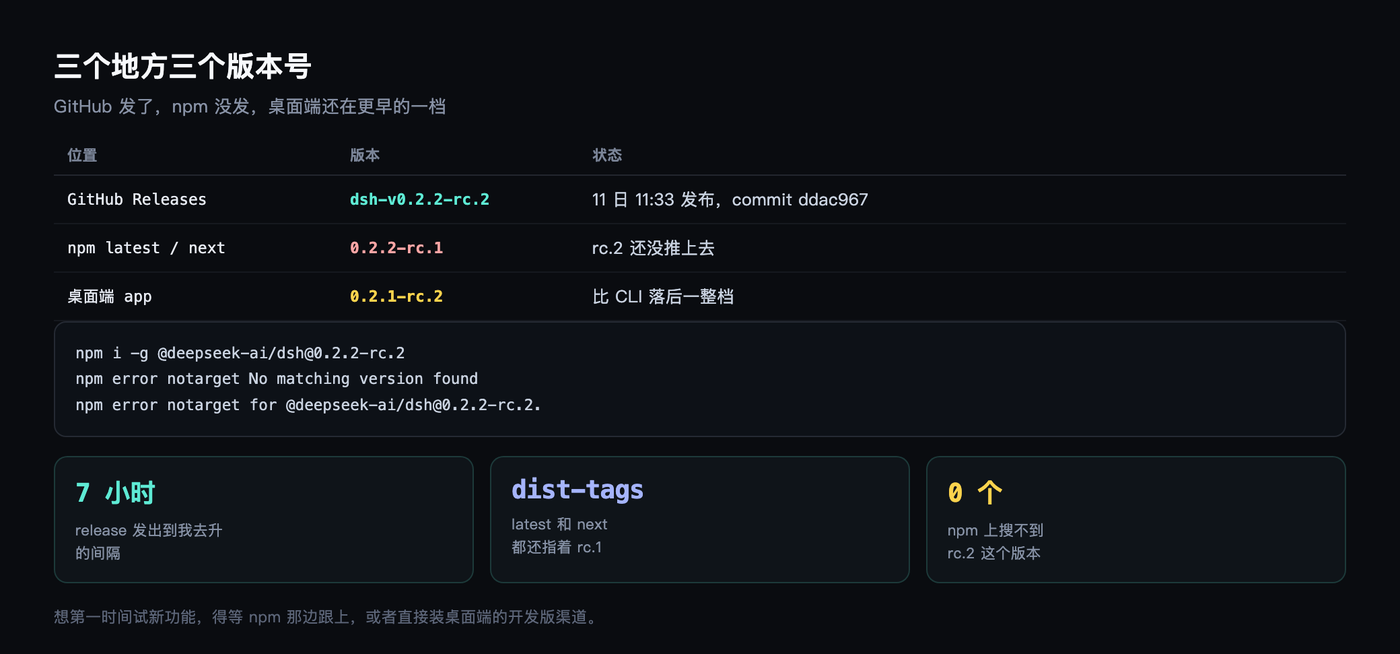
桌面端更早,还停在 0.2.1-rc.2。也就是说我机器上同时躺着三个版本号,一个都没到 rc.2。
这不是 DeepSeek Harness 的毛病,发版流程都这样。但它决定了你什么时候能真的用上新功能:要么等 npm 追上,要么去桌面端切开发版渠道,而那个渠道本身就是 rc.2 里新加的。
换个路子自己测
装不上,我就把 DeepSeek Harness 这次要做的事在本机复刻一遍。
工作树、按分支比、按文件类型切,这些底层动作全是 git 命令,跟客户端无关。我用自己那个 21,711 个文件、60,037 次提交的仓库当靶子,旁边配一个 50 个文件的小仓库做对照。
先测最费时间的那一步:建工作树。
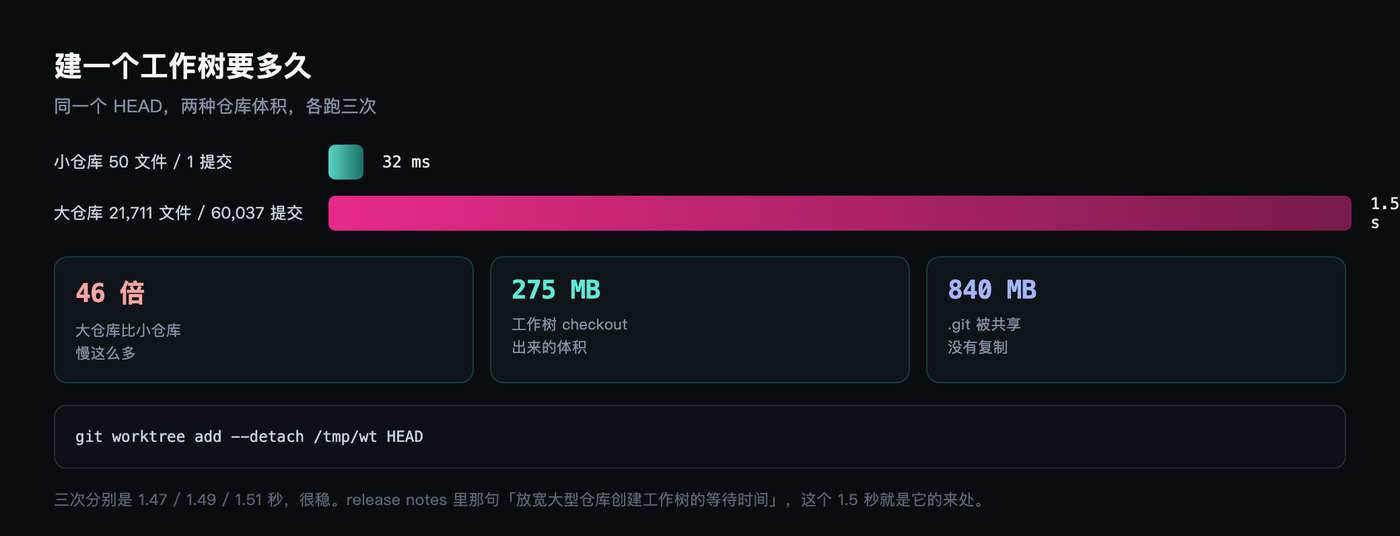
小仓库 32 毫秒,跑三次是 31、32、32。
大仓库 1.5 秒,三次 1.47、1.49、1.51,很稳。差了 46 倍。
工作树 checkout 出来占 275 MB,但 .git 是共享的,840 MB 那个仓库没被复制一遍。这点设计省了不少磁盘。
1.5 秒不算长,可如果 agent 每改一次代码就建一个工作树,中间还夹着网络往返、磁盘抖动和一堆看不见的等待,这个 1.5 秒就会变成一个随时可能超时的赌注。release notes 写道「放宽大型仓库创建工作树的等待时间」,说的就是这个 1.5 秒。
三种审阅维度,全是毫秒
我在工作树里造了两轮改动,模拟 agent 干活:40 个文件一轮,240 个文件一轮,累计对主分支 311 个文件、28,458 行。
然后按它说的三个维度各比一遍。
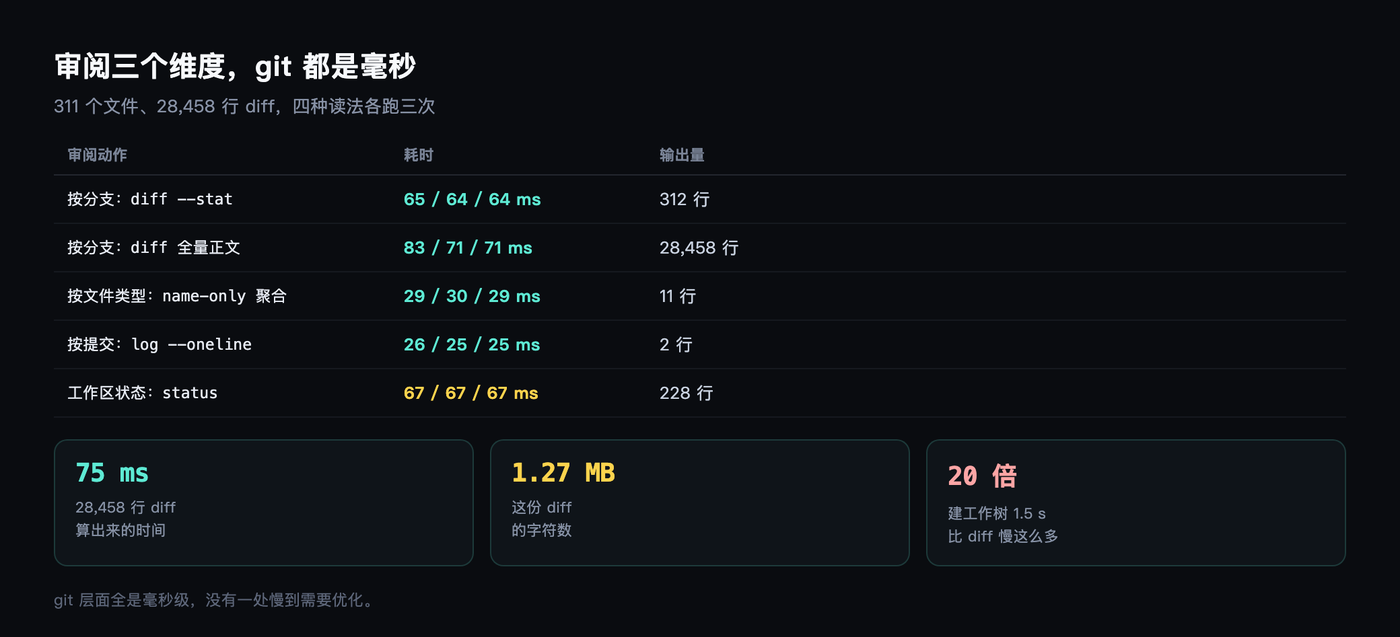
按分支看统计,65 毫秒。全量正文,75 毫秒。按文件类型聚合,29 毫秒。按提交看日志,26 毫秒。
四个维度全在百毫秒以内,git 层面没有一处是慢的。
这里有个反直觉的地方。28,458 行、1.27 MB 的 diff,git 算出来只要 75 毫秒,我原本以为它会是大头,结果它是全场最快的那个。
基线选错,审的是空气
这里我踩了个坑,值得写出来。
第一次跑对比,我用的是 git diff main...HEAD。三个点,意思是拿两个分支的共同祖先比。结果输出 0 个文件。
原因很简单:我那个仓库的本地 main 早就落后,HEAD 本身就是 main 的一个祖先。共同祖先算出来是 HEAD 自己,自己跟自己比,当然是空的。
换成 origin/main...HEAD,立刻变成 311 个文件。
同一个仓库,同一个分支,只换基线,从 0 变成 311 个文件。
所以「按分支审阅」这件事,真正需要小心的不是 diff 慢不慢,是它到底在跟谁比。agent 的分支如果是从一个旧基线上拉出来的,你审出来的东西会少一大截,而且不会有任何提示。
三个点比共同祖先,两个点比两个端点。这个区别平时不重要,一旦交给 agent 自动审阅,就变成了能不能看见改动的分水岭。
那 28,458 行怎么读
既然 git 不慢,慢的必然是别处。把 diff 按扩展名拆开,答案就浮出来了。
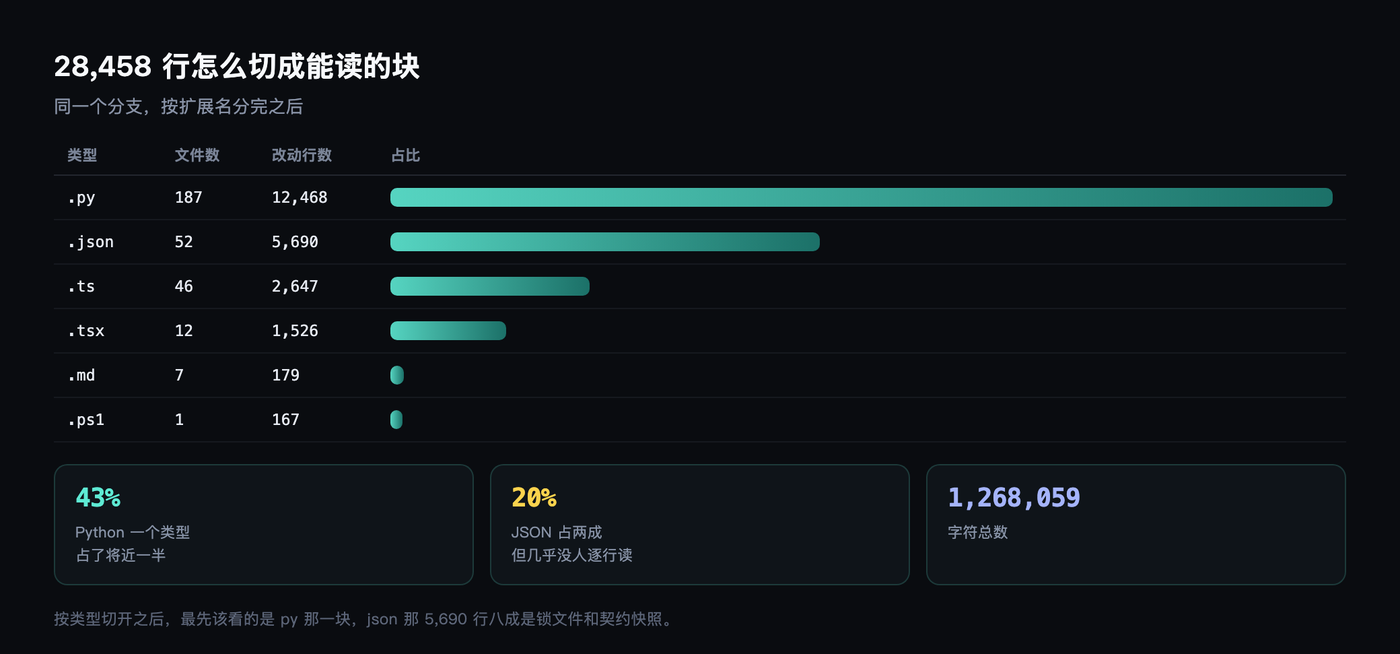
Python 187 个文件、12,468 行,占 43%。JSON 52 个文件、5,690 行,占 20%。TypeScript 46 个文件、2,647 行。TSX 12 个文件、1,526 行。
有意思的是 JSON 那 5,690 行。锁文件、契约快照、配置导出,占了五分之一的行数,但真正要逐行读的不到百分之五。
按文件类型审阅这件事,价值不在于分类好看,在于它让你有理由跳过一整个 5,690 行的文件夹。
工作树省的不是磁盘
我原本以为工作树会占很多盘,实测下来这个担心多余。
21,711 个文件、840 MB 的 .git,建出来的工作树只占 275 MB。因为 .git 是共享的,复制出去的只有工作区文件。
这 275 MB 买到的是一份隔离:同一个仓库里可以有多个工作树,各自挂在不同的分支上,互不干扰。agent A 在 feat-a 上改代码,agent B 在 feat-b 上改另一处,两边的工作区和索引都是各自独立的。
换成沙盒或者整个仓库副本,你要付的是 840 MB 的磁盘加几十秒的拷贝时间,而工作树付的只是 1.5 秒,还顺带把分支隔离这件事免费送给了你。
这也是它把审阅做在工作树上的原因。分支在那儿,提交在那儿,文件也在那儿,按哪个维度切都是现成的原料。
瓶颈在上下文,不在工具
把每一环的数字摆在一起,结论就很清楚。
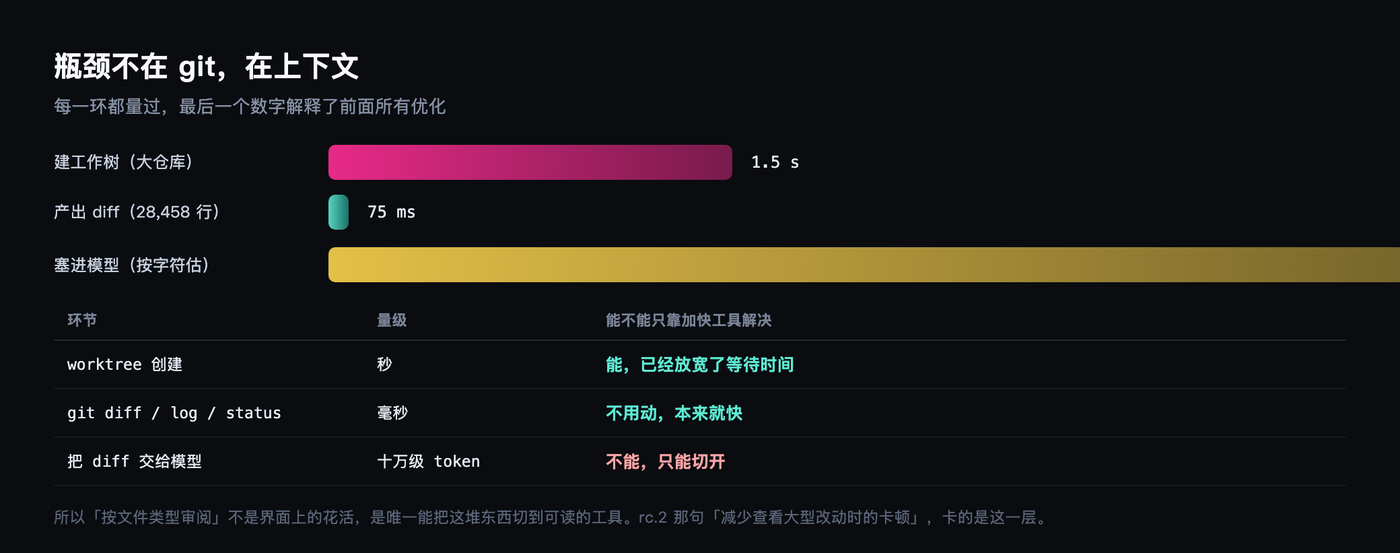
建工作树 1.5 秒。产出 diff 75 毫秒。
把这份 diff 交给模型,1,268,059 个字符,粗算三十万 token。
三十万 token 是什么概念?现在主流模型的上下文窗口在二十万上下,这一个改动的 diff 就装不下,还没算上仓库结构、任务描述和你的提问。
所以 rc.2 那句「减少查看大型改动时的卡顿」,官方描述指出卡的不是 git,是把这堆东西渲染出来、送进模型、再让人读的那一层。前面几个毫秒级的数字再怎么优化都没用,因为真正的天花板在这里。
按文件类型、按提交、按分支,这三条路径本质上是三种切法。切得动,模型才读得完。
另一条我还没试的
rc.2 还加了两件事:SubAgent 支持具名与多层协作,AgentTeam 可以按会话开启,共用成员和任务面板。
这个我没法在本机复刻,因为它不是 git 层面的事,是编排层的事。而且 npm 上装不到 rc.2,我手上只有 rc.1,跑出来也不是 rc.2 的行为。
所以我只写我验过的部分。这条留给能用上的人。
你现在可以做的
如果你的 agent 已经开始在分支上干活,有两件事现在就能改。一是给工作树准备一块快的盘,1.5 秒里大半是磁盘 IO,放在机械盘或者网络盘上会更慢。
二是先看统计再看正文。312 行和 28,458 行之间差 90 倍,先读前者,能过滤掉一半不需要看的文件。
至于 DeepSeek Harness 的 rc.2,等 npm 追上就行。装上之后第一件事建议是拿自己最大的那个仓库跑一遍建工作树,看看你那台机器上是 1.5 秒还是 15 秒。
这个数字决定了你以后要不要让它频繁开分支,也决定了你的流水线里能不能跑多个 agent 并行改同一份代码。一台机器上 1.5 秒和 15 秒的差别,最终会变成流水线里「三个 agent 一起跑」还是「老实一个一个来」这样两种完全不同的架构选择。