JetBrains 的研究员翻了 4,782 段真实会话,都是工程师在自己 IDE 里跟 coding agent 的对话,一共约 14,000 条用户消息。
结论一句话:你现在用来给 agent 打分的那些基准,测的根本不是人怎么用它。
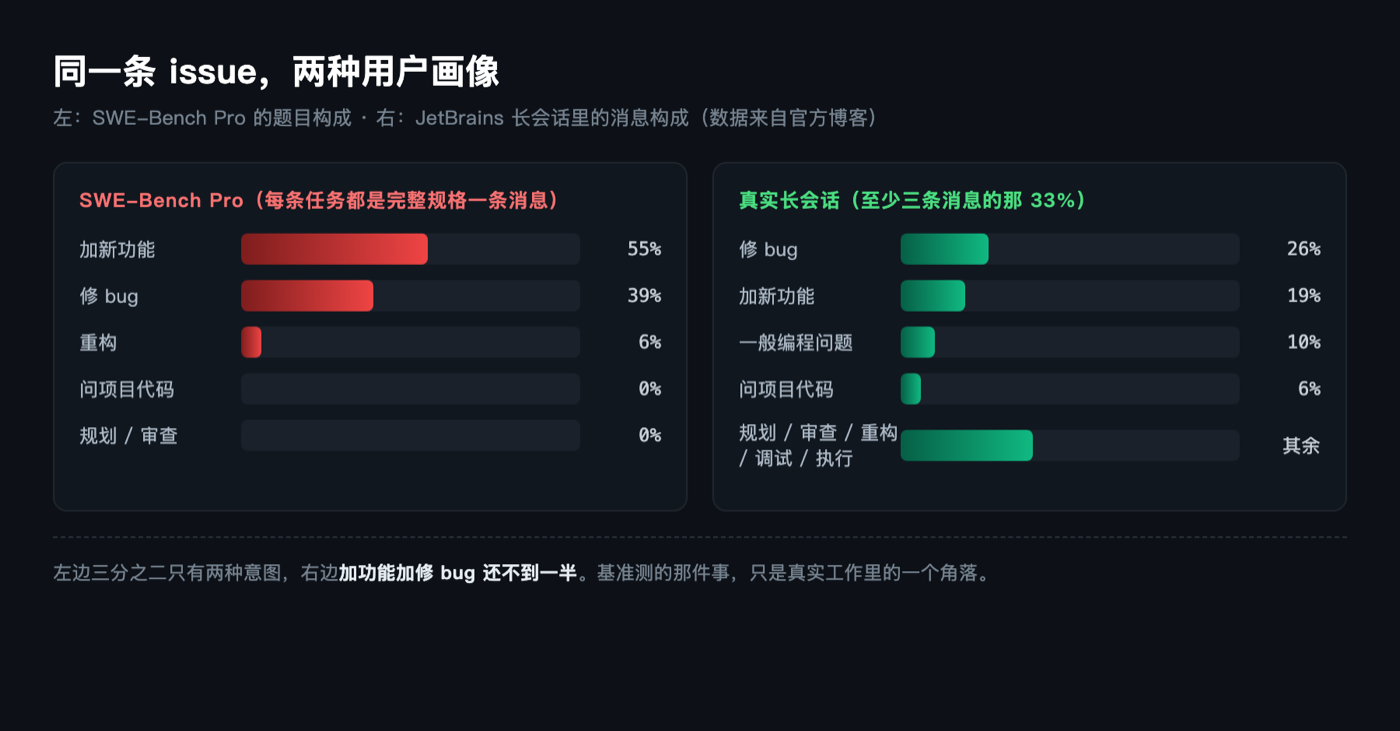
SWE-Bench Pro 里 93.8% 的任务是加功能和修 bug,而且每条任务都是一条完整的消息扔过去,agent 一次看清全貌再动手。
真实会话里,加功能只占 19%,修 bug 占 26%,两个加起来不到一半。
剩下的在干什么?问代码怎么运作的占 6%,一般性编程问题占 10%,还有规划、代码审查、重构、跑命令、调试,这些事在 SWE-Bench Pro 里一项都没有,因为那个基准的题目定义里根本不存在「问一句」这种动作。
一半的会话只有一条消息
他们把每条会话按用户消息数数了一遍。
50.9% 的会话只有一条消息,16.2% 两条,8.8% 三条,往后再数到五条,加起来的比例已经不到 15%。
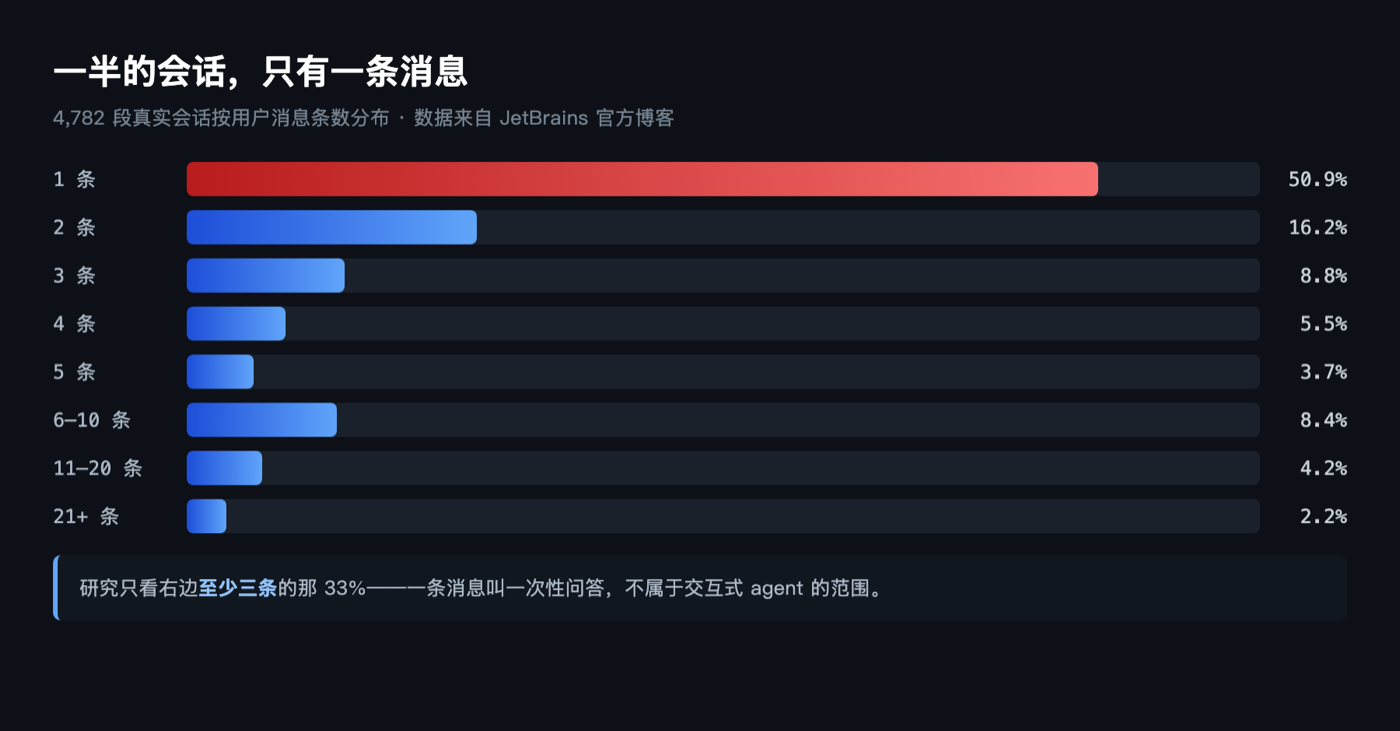
所以后续分析只看「至少三条消息」的 33%,他们叫长会话,一条消息那叫一次性问答。长会话里消息的构成是这样:问项目自己的代码 6%,一般编程问题 10%,剩下的分散在规划、审查、重构、调试、执行上,加功能和修 bug 已经被稀释成小头。
而 SWE-Bench Pro 被同一个分类器标过之后,是 55% 加功能、39% 修 bug、6% 重构。然后没了。
三个公开语料,三种完全不同的走法
他们还拿三个公开的 agent 对话集做了同样的标注。
SpecStory 是公开的 IDE 会话导出,1000 条里有 521 条是长会话,最接近他们自己的数据,规划占比明显高。
DataClaw 是社区分享的会话,585 条长会话,几乎全是执行类和短指令。SWE-chat 是真实用户在聊天界面里的记录,698 条长会话,执行和规划最多。
三个数据集来自不同产品、不同用户、不同采集方式,所以他们不做数量对比。但有一点很硬:拿其中任何一个当标准去校准基准,得到的题目配比都不一样,而这种差别不是样本量能抹平的。
连他们自己的 4,782 条也不算真相。用他们的话说,目标得先选定,再声明出来;没有默认的那一个。
这句话是整个研究的骨架。以前大家默认「用 GitHub issue 造任务就是真实的」,这篇说不是,issue 只是众多人群里的一种,换一批人数据就换一副样子,谁也没有资格说自己的那份是标准。
他们没造新基准,而是改装旧基准
新建一套交互式基准,等于把 SWE-Bench 这些年攒的仓库、环境、测试全扔了。所以他们选了另一条路:任务、仓库、测试、原始需求全留着,只重写用户消息。
做法是把每个 issue 拆成三条有序请求,凭空捏造的内容一点也不许有。每条请求必须能在上一条留下的代码状态上动手,标识符和代码片段原样保留,拆完再用另一个模型检查一遍有没有丢需求。731 条公开的 SWE-Bench Pro issue 里,31 条没过校验,剩下 700 条。
700 条就是全部战场,后面的所有数字都从这儿来。
原来的 issue 大概一千字一条消息,全塞在一段里。拆完之后长这样,第一句只给主症状,边界条件留到第二第三条。
qutebrowser 有个 LinkedIn 打不开的 issue,原因是老版本 QtWebEngine 缺 Array.prototype.at。
第一条请求只说「修一下 LinkedIn 在 macOS 上加 QtWebEngine 5.15.2 打不开的问题,用 polyfill 兜住」。
第二条才补「必须覆盖 6.3 之前没有原生支持的版本,正索引和负索引都要对」。第三条才说「越界要返回 undefined,只在原生方法缺失时才注入」。
三条一对,一条消息里的完整规格被摊成了三次渐进披露。
还往里塞了「问项目本身」的问题
真实会话里 6% 是在问项目代码怎么回事,这类任务 issue 基准里一条都没有。于是他们让模型读仓库加一条已经解过这道题的轨迹,生成一到三个问题。
每个问题带两样东西:一份参考答案,和一个能跑的证据脚本。造数据集时在干净仓库里跑一遍,跑不出证据、或者改动了仓库,这题直接扔。
这条规则顺手排掉了一类问题:答案不在代码里的(「当初为什么这么设计」),物理上不存在。
qutebrowser 那道题后来配了一个问题,答案里点了两个配置项、走了五个文件。
拆完之后,成本翻倍,分数没动
下面是全文最值钱的一段,四个模型、700 条任务、三种喂法、每种跑三遍。
单发就是原始 issue 一条消息扔过去。拆分是把三条请求依次发,中间不补充。拆分加问答是再加进那些仓库问题,位置由优化器选。
结果是拆分让每个模型的成本涨了 2.0 到 2.6 倍。
仓库没变、测试没变、需求一条没加,多出来的钱全花在「需求分批到货」这件事上。
分数几乎没动。GPT-5.6 Terra 持平,其余三个平均掉 4 到 5 个点,跟同一种设置反复跑三次的波动差不多。
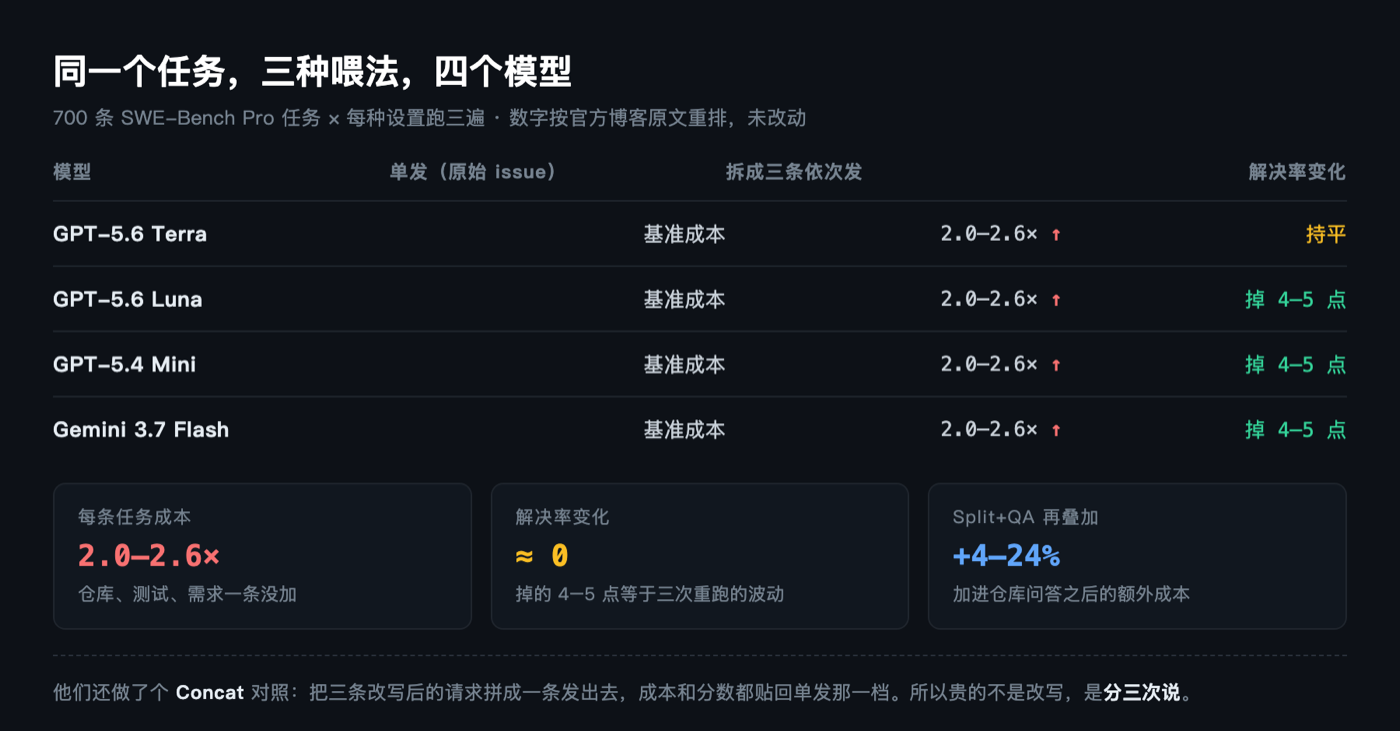
他们还做了个对照,把三条改写后的请求拼成一条发出去,三个 GPT 模型的成本和分数都贴回单发那一档。所以贵在用三条发这个动作上,不是在改写措辞上。
拆开之后有了中间检查点
一条长需求跑到底,你只拿到一个最终分数,对错全糊在里面,想知道是哪一步塌的只能自己回去翻轨迹。拆成三步就能在每一步跑一次测试,只按已经露出来的需求判分,错在哪一步一眼看得出来。
64 条任务的消融里,通过率和测试通过率随着每条请求往上爬。一个问题变成几个可核验的检查点,诊断起来清楚得多。
这大概也是拆分唯一的收益,除此之外它只有成本。
它还没解决什么
只生成了两种消息:拆开的需求,和问仓库的问题。真实会话里的规划、审查、执行、没有修复的调试,全都还没生成器,而且大部分连「怎么自动判对错」都还没想清楚。
还有一条:所有消息在跑之前就写死了。可复现是真的,「用户」不会根据 agent 回应改口也是真的。
研究到此为止,剩下那些他们自己列了一串没做的,末尾连「分类器没有人工标注的准确率集」这种短板也写上了。
这个结论对写代码的人有什么用
以前看模型榜单,默认那个数字代表「它有多会写代码」。这篇的说法是,那个数字里还包着一样你从来没在选择的东西,就是它被要求用什么样的节奏干活。
同一个模型,需求一次给全还是分三次给,成本差一倍多,分数差不多。那你在自己项目里怎么提需求,就是一道单独的题,而且是你能控制的那道。我平时的习惯是一条消息把背景、目标、约束全写清楚,看完这篇不打算改,真到了纠结成本的时候,先看的是它多绕了几步,而不是它答得对不对。
一个有趣的推论:如果所有基准都按「一次给全」来测,被训练出来的模型也会习惯这种节奏,那真实会话里那些追问、纠偏、渐进披露的能力,谁也测不出来。
回头看你最近的几次 agent 会话,是一条消息解决的多,还是来回好几轮的更多?