JetBrains Research 在 10 月 29 日发了篇博客,标题直译过来是《能自己写自己的 Prompt:一个 Kotlin 实验》。
作者 Nikita Khramov 和 Anton Podkopaev 在文里写道,这不是比喻。他们真的让机器把 agent 里的提示词改了一遍,改完的版本比人手写的长了两千倍。
我把这个实验的仓库拉下来跑了一遍编译,代码能过。下面说说它到底怎么改的,改出了什么,值不值得你花力气。
改动的地方只有一个参数
Koog 里 agent 是一张有类型的图,节点和边声明控制流,每个节点带自己的提示词、工具和模型。
官方给的例子把 PAPILLON 那条隐私管线用 Koog 重写了一遍。用户的查询里带着个人信息,agent 要拿大模型帮忙回答,但不能让模型看见那些信息。三步走完:先把问题脱敏,再调那个不受信任的模型,再拿回结果写成回复。
三步里有两步的提示词是人写的。要交给机器改,只需把 subgraphWithTask 换成 optimizableSubgraphWithTask,再把写在字符串里的那段指令挪出来,单独传给 optimizableInstruction。
val craftRedactedRequest by optimizableSubgraphWithTask<PupaAgentInput, PupaRedactedRequest>(
    name = "craft_redacted_request",
    optimizableInstruction = REDACT_INSTRUCTION,
) { _, input -> "user_query:\n${input.userQuery}" }
图本身一行没动。指令只是从字符串进了参数位,那个位置优化器认得,能读也能换。没有优化产物可加载的时候,就退回你写的那段原文跑。
谁来改,凭什么改
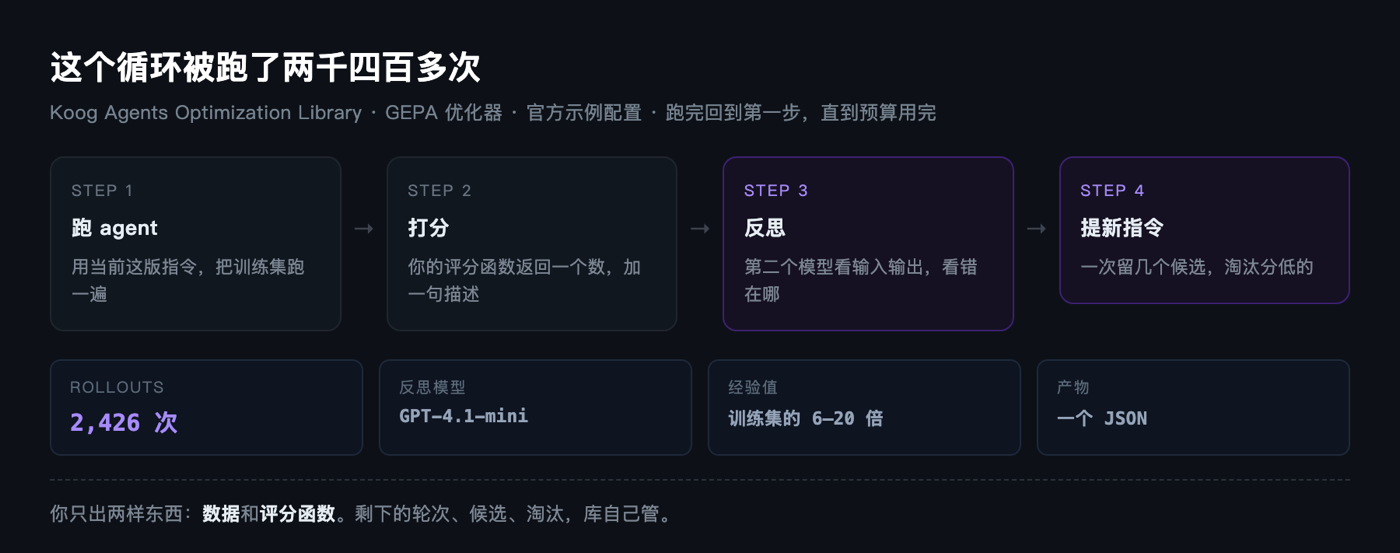
改动方是第二个模型。你的 agent 跑一遍,第二个模型看结果,看错在哪儿,然后提一版新指令,再跑,再改。一轮一轮,在预算内重复。
它需要知道什么叫好。所以你得提供一个函数,每次跑完返回一个分数,再加一句这次跑得怎么样的描述。分数决定哪些候选活下来,那句话是给第二个模型看的。
官方那个例子里,这句话只有一行。
PUPA overall score: 0.50. Quality score: 1.00. Privacy score: 0.00. PII leakage ratio: 1.00.
就这一行,加上这一步收到的输入和产出的输出,是机器改写的全部依据。
跑了两千四百多次
配置里写着 numRollouts = 2426。代码注释里有句实在话,一个实用的起点是训练集的六到二十倍。
反推一下,这意味着训练集在一百到四百条之间。这个量级不算大,但也不小,你得先有数据,还得有能给人打分的流程。
反思模型用的是 GPT-4.1-mini。为什么用这么小的模型,博客没细说,我猜是因为它要在两千多轮里每次都读一遍输出,用大模型成本扛不住。
改出来的东西,人不会那么写
脱敏那一步,原来的指令两行:
Given a private user query, create a privacy-preserving request for a powerful external LLM. The LLM may assist without learning private information about the user.
故意模糊,一个字没说清脱敏到什么程度算够。
跑完之后,同一处变成 4,456 个字符。
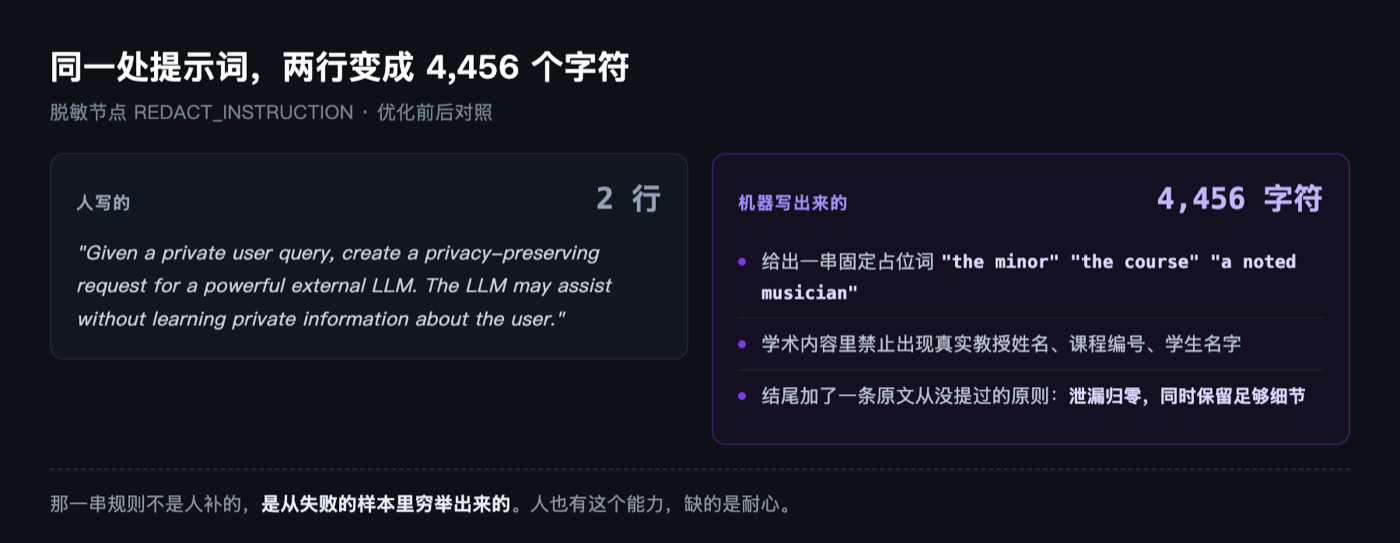
里面有几段特别有意思。它列了一串占位词,像 “the minor”、“the course”、“the company”、“a noted musician”、“two large urban communities”。
它还规定,学术内容里不能露出真实的教授姓名、课程编号、学生名字。
结尾那条最有意思:泄漏归零,同时保留足够细节让模型能干活。
结尾那句是权衡。原文里没人写过,它从失败的样本里自己总结出来的。
我不觉得这是机器比人聪明。它做的是一件人懒得做的事,把几十个失败案例的共同点穷举成规则。人有那个能力,没那个耐心。
它和你手动调 prompt 的差别
手调的逻辑是,改一版,跑一遍,看分数,再改一版。一次只有一个假设,而且改哪儿靠直觉。
机器调的逻辑是,一次提出好几个候选,同时跑,留下分数高的,淘汰低的。它还会看成功的样本,不只是失败的。这一点挺关键,因为只看错误容易把 prompt 改得越来越保守,越写越像免责声明。
两千四百多次 rollout 换来的东西,本质上是把你的直觉换成了搜索结果。搜索不一定更聪明,但它不累,也不会因为凌晨三点困了就随便收工。
代价是电费和时间。这个实验的规模,一个人手动跑不出来。
分数涨了十三
PUPA 这个基准,基线 81.19,已经很挤,往上抬不容易。优化后 94.22,涨了 13 分。
两个数字都是五次运行的均值,官方说这个提升统计显著。
其他基准的数字在文档里,和原始实现的对照也在。他们没把话说满,只详报了这一个案例。
同一个接口下还有三个
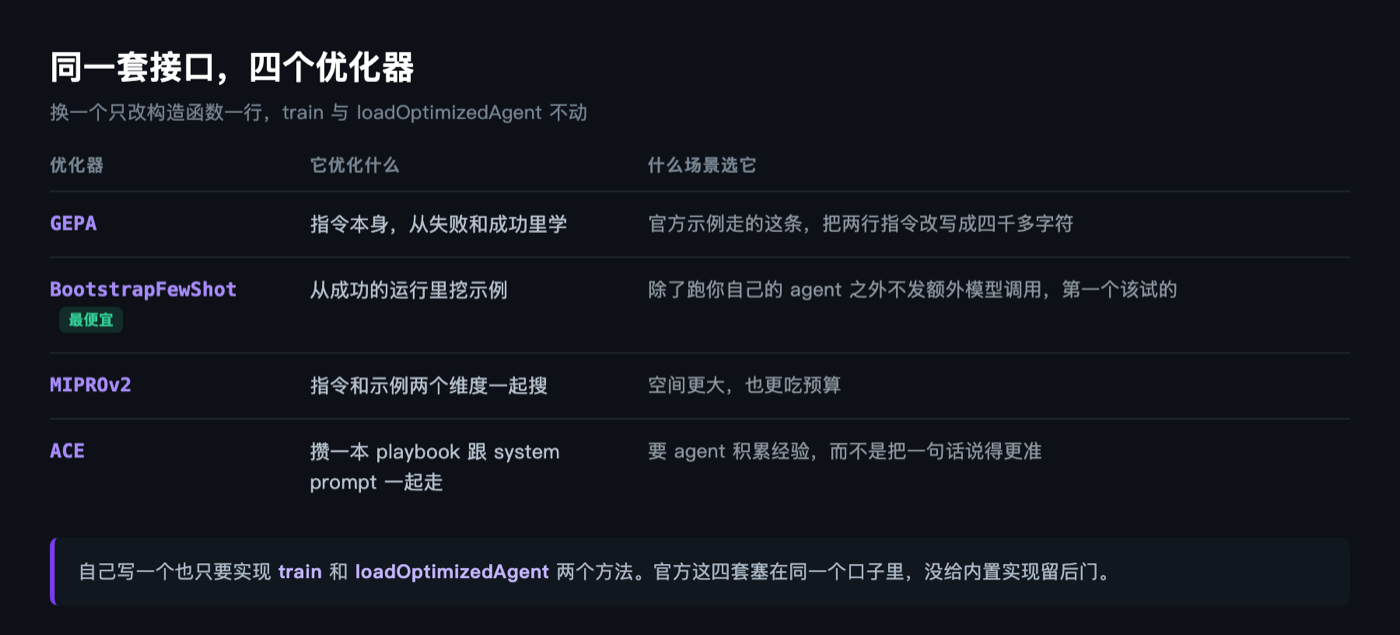
除了 GEPA,这个库还实现了三个优化器,接口完全一样。
BootstrapFewShot 从成功的运行里挖示例,除了跑你自己的 agent 之外不发额外的模型调用,是最便宜的第一个选项。MIPROv2 同时在指令和示例两个维度上搜。ACE 攒一本 playbook 跟着 system prompt 走,适合你要 agent 积累经验而不是把一句话说得更准。
换优化器只改构造函数一行,前后的 train 和 loadOptimizedAgent 都不用动。自己写也只需要实现这两个方法,官方这四套都能塞进同一个口子,没留后门。
关于那个 fork
博客的原话是,optimizable-subgraph 的支持目前在一份 Koog 的 fork 里,预期会合回上游。
这句我实测对不上。库的 gradle 里写的是 koog 1.1.1,Maven 上的正式版,工程里没有任何依赖替换。两个模块,优化库本身和跑 PAPILLON 的那个示例,都在正式版上编过了。至少到编译这一步,不需要什么分支。
它跟主干具体差在哪儿,我核不出来。博客自己说预期会合回上游,那就等它合。仓库不会撒谎,博客可能早写了一句。
为什么只有四颗星
这个库到今天 4 颗星,6 月建仓,Apache 2.0,128 个 Kotlin 文件,一万七千行。同门的 Koog 有 4,645 星。
原因不难猜。它要你先准备好测试集和评分函数,这两样东西恰恰最费人力,而库本身只省了你调措辞的时间。
你用不上,不是它不好,是你手头还没攒够那两样东西。
这件事改变的是什么
写提示词从手艺变成编译。
以前你写 prompt,靠肉眼看、靠感觉调。现在可以声明哪几段是待优化的,准备数据,定好评分,让机器跑几百上千轮,拿到一个 JSON,读一遍、审一遍、提交进版本库。
prompt 从此有了 diff。
分数涨 13 分是这一个案例的结果。提示词能被自动优化、能进代码评审,这件事会改变所有写 agent 的人的工作方式。
你自己的项目里,有几条提示词是能被自动评测的?